Це багатосторінковий друкований вигляд цього розділу. Натисність щоб друкувати.
Блог Kubernetes
- Чому мій Kubernetes Job досі в черзі? Відстеження допуску Kueue в Headlamp
- Kubernetes v1.37: Представляємо стани життєвого циклу вузла
- Kubernetes v1.37: Storage Version Migration типово увімкнена
- Kubernetes v1.37: Garhwal
- Створення власного експортера метрик для Kubernetes
- Керування AI/ML навантаженнями в Kubernetes: втулок Headlamp для Kubeflow
- Представляємо втулок Cluster API для Headlamp
- Представляємо контролер готовності вузлів
- Експерименти з Gateway API за допомогою kind
- Cluster API v1.12: Впровадження оновлень на місці та ланцюгових оновлень
- Kubernetes v1.35: allowList для exec-втулків у kuberc обмежує виконувані файли, які запускає kubeconfig
- Kubernetes v1.35: Кращий спосіб передачі токенів ServiceAccount до драйверів CSI
- Kubernetes v1.35: Розширені оператори tolerations для підтримки числових порівнянь (Alpha)
- Kubernetes v1.35: Новий рівень ефективності завдяки перезапуску Podʼів на місці
- 7 типових помилок Kubernetes (і як я навчився їх уникати)
- Попередній огляд Kubernetes v1.34
- Оголошення про випуск etcd v3.6.0
- Огляд Kubernetes v1.30
- pkgs.k8s.io: Представляємо репозиторії пакунків від спільноти Kubernetes
Чому мій Kubernetes Job досі в черзі? Відстеження допуску Kueue в Headlamp
Ви подаєте Kubernetes Job і чекаєте, поки зʼявляться його Podʼи. Хвилина минає. Потім ще одна. Job досі призупинено, журналів застосунку немає, а Podʼа для перевірки може й не бути.
У кластері, керованому Kueue, це цілком може бути нормою. Kueue досі може вирішувати, чи може Job використати запитані ресурси. Корисне питання полягає не лише в тому, «чому Pod у стані очікування?». Насамперед варто запитати: «Чи здійснив Kueue допуск (admission) цього Workload?».
Втулок Kueue для Headlamp переносить це розслідування в інтерфейс Headlamp. Замість того, щоб відтворювати шлях допуску за допомогою кількох команд і обʼємних YAML-обʼєктів, ви можете почати з Workload, прочитати повідомлення його стану (condition) і перейти за посиланнями до LocalQueue, ClusterQueue, ResourceFlavor і Cohort.
Ця стаття присвячена саме цьому підходу: спершу Headlamp, а командний рядок зʼявляється лише в короткому необовʼязковому розділі для відтворення прикладу.
Підготовка
Вам потрібен кластер Kubernetes зі встановленим Kueue, встановлений Headlamp та втулок Kueue 0.1.0-alpha. Ваш обліковий запис Kubernetes повинен мати права на читання ресурсів Kueue, що використовуються в цій статті.
Альфа-версія надає режими перегляду лише для читання ресурсів Kueue v1beta2: Cohorts, ClusterQueues, LocalQueues, ResourceFlavors та Workloads. Вона не додає власних робочих процесів створення, редагування, зупинки, відновлення чи видалення. Headlamp як і раніше надає стандартні дії з YAML і ресурсами, якщо ваші дозволи це допускають.
Спершу відокремте допуск від планування Podʼів
Kueue та планувальник Kubernetes відповідають на різні питання.
- Допуск Kueue (admission): чи слід запускати цей Workload зараз, з урахуванням політики черги (queue), квоти, ResourceFlavorʼів, перевірок допуску (admission checks) та інших Workloadʼів в очікуванні?
- Планування Podʼів: після того як Kueue здійснює допуск Workload і Job поновлюється, на яких вузлах можна виконати його Podʼи?
Межа між цими двома змінює саме розслідування. Якщо Workload не допущено, залишайтеся в розділі Kueue в Headlamp. Якщо допущено, але Podʼи досі в стані Pending, переходьте до звичайних режимів перегляду Job і Pod у Headlamp і перевіряйте події планувальника.
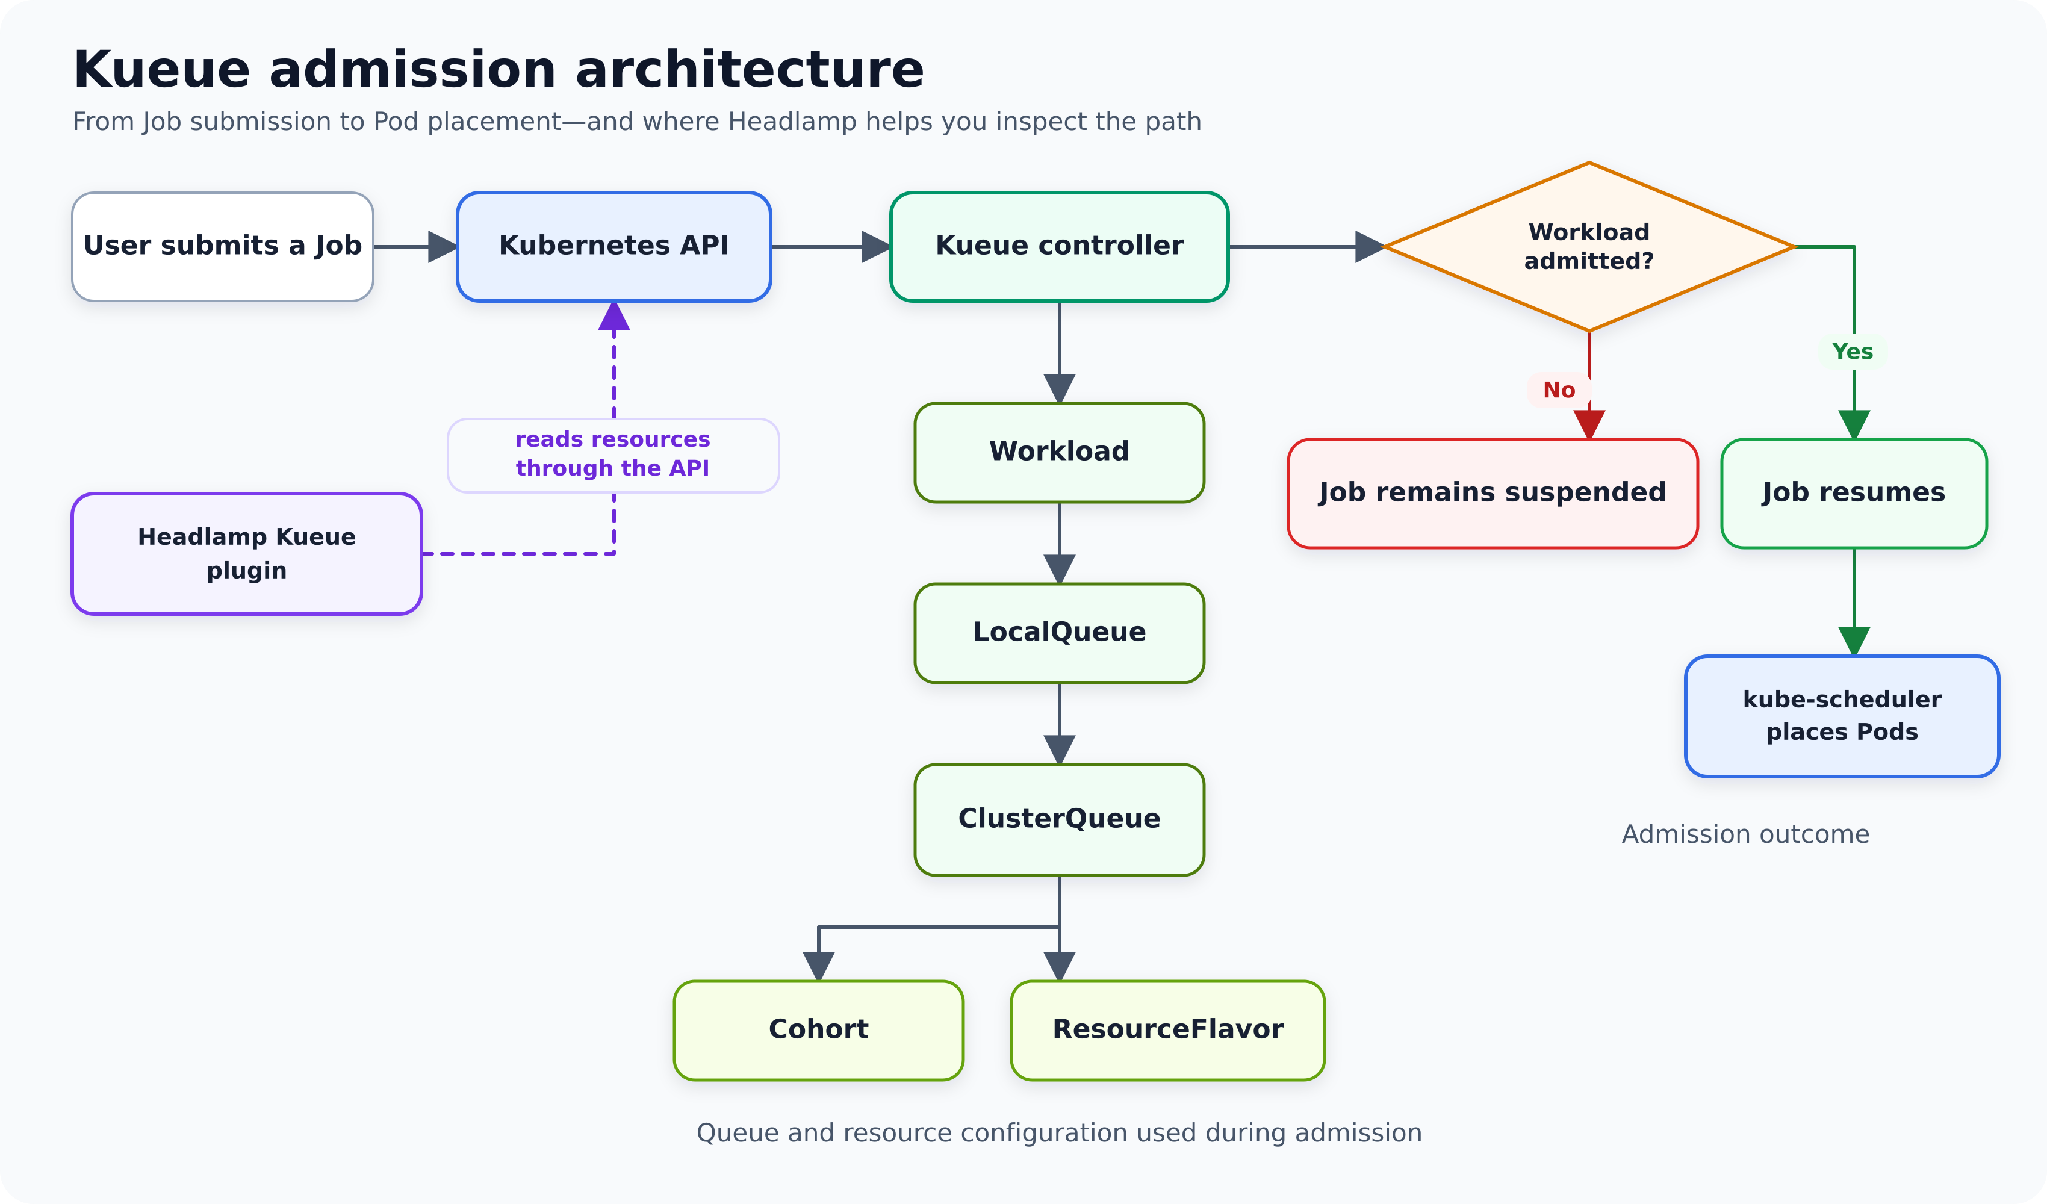
Архітектура допуску Kueue
Шлях усунення несправностей із Headlamp на першому місці
Найшвидше розслідування починається з Workload, а не з командного рядка.
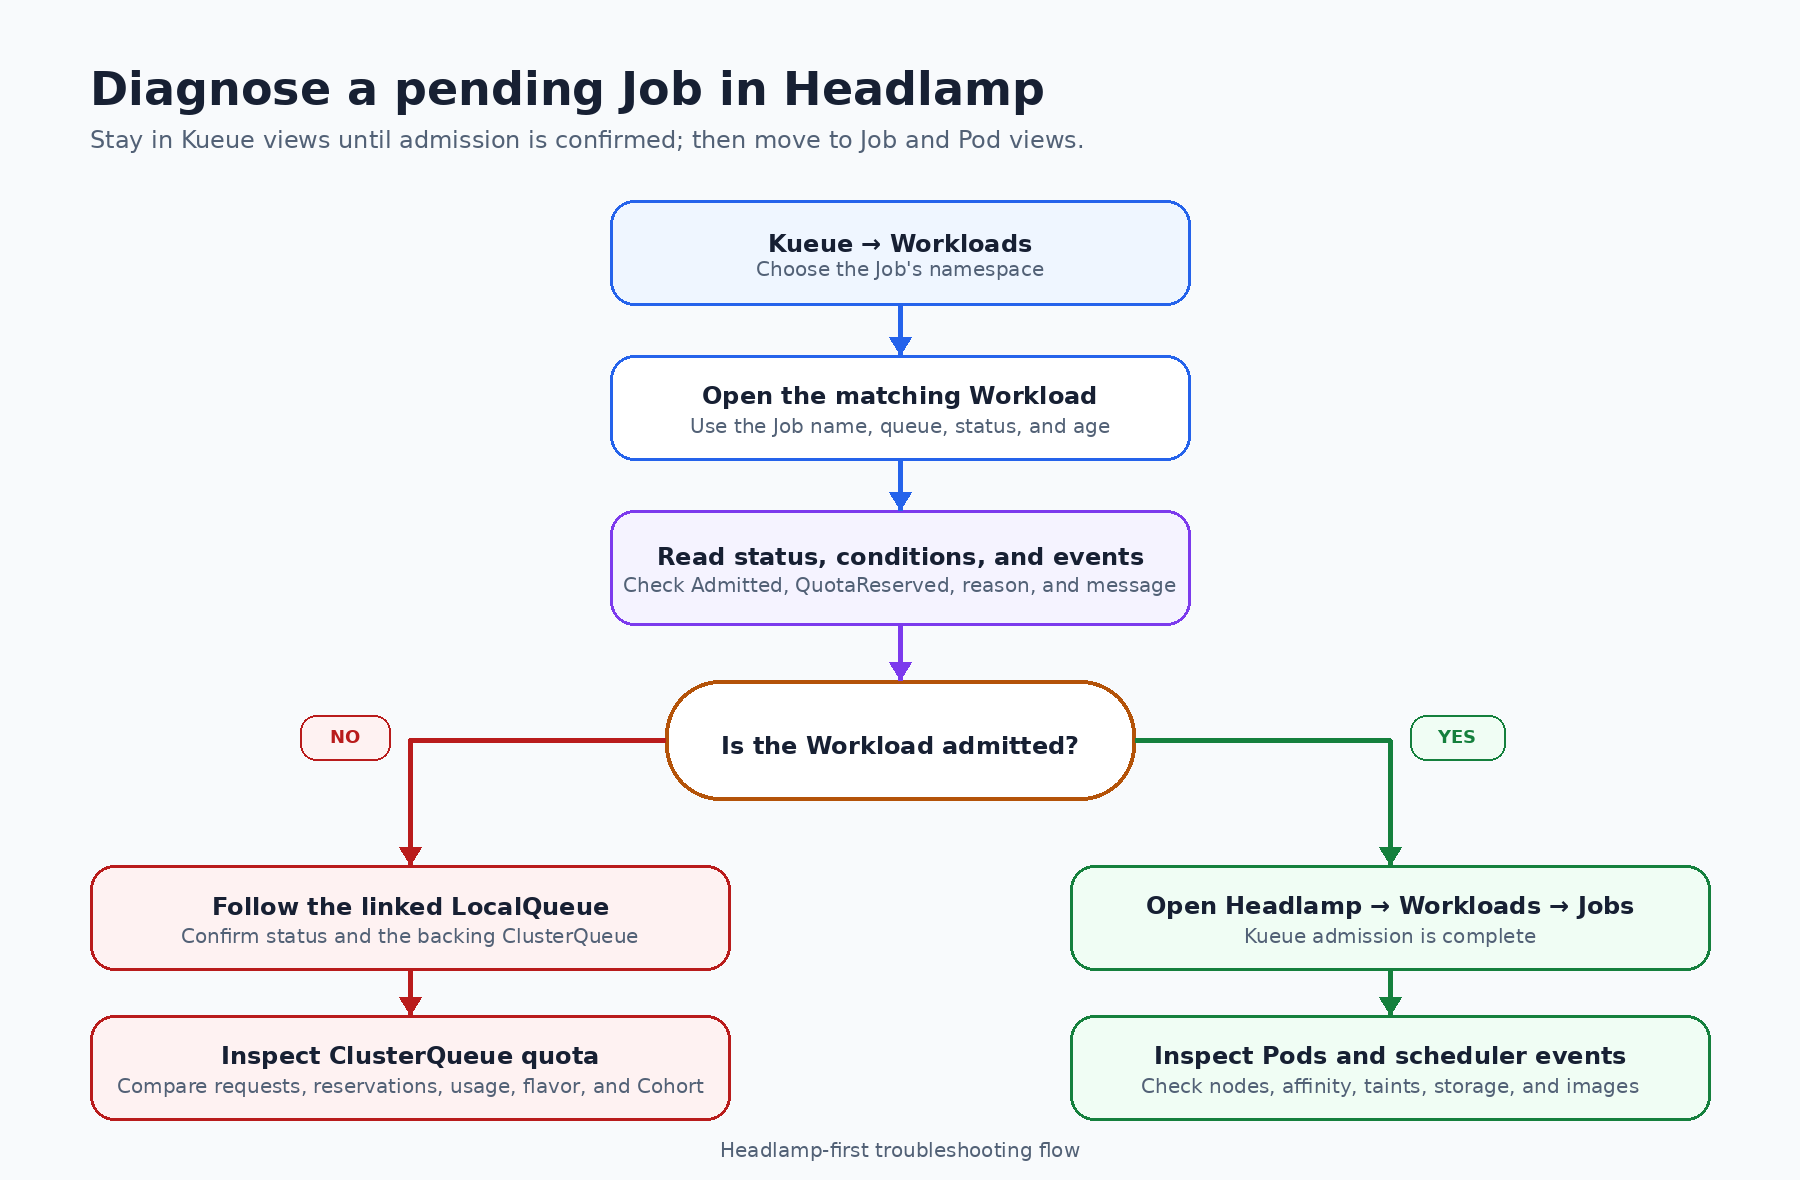
Відстеження Job в очікуванні за допомогою Headlamp
Крок 1. Відкрийте режим перегляду Workloads
У Headlamp відкрийте Kueue → Workloads. Виберіть простір імен (namespace), що містить Job, а потім знайдіть Workload, створений для нього.
Kueue створює Workload, що представляє запит ресурсів і стан допуску Job. В альфа-версії втулка посилання на власника показані як текст у форматі Kind/name, але поки не є посиланнями. Назва Workload зазвичай містить назву Job, тож фільтр за простором імен і пошук у таблиці — найпростіший спосіб його знайти.
Ще до відкриття сторінки подробиць список уже дає корисний перший огляд:
- LocalQueue
- пріоритет і клас пріоритету
- активний стан
- стан допуску (admitted)
- стан завершення
- зрозумілий поточний статус, як-от
Admitted,FinishedабоInadmissible - вік
Якщо відповідного Workload немає, перевірте три речі, перш ніж іти далі: вибраний простір імен, чи було Job подано до LocalQueue, і чи може ваш обліковий запис Kubernetes перелічувати Workloads. Втулок виконує перевірки дозволів і показує повідомлення про доступ, коли поточний обліковий запис не може прочитати ресурс.
Крок 2. Прочитайте статус, стани та події
Відкрийте Workload. Почніть з його поточного статусу та станів (conditions), а не з повного YAML.
Для усунення несправностей допуску найважливіші типи станів — це QuotaReserved і Admitted.
Admitted=Trueозначає, що Kueue здійснив допуск Workload. Job може поновитися, тож усі Podʼи, що лишилися в станіPending, належать гілці розслідування, повʼязаній із плануванням.QuotaReserved=Falseз причиною, як-отPending, означає, що Kueue не зарезервував квоту. Повідомлення стану пояснює, що завадило резервуванню.- Статус
Inadmissibleозначає, що Workload поки не вміщується в доступну конфігурацію черги. До цього можуть призвести відсутність ресурсу в наборі квот, непридатний ResourceFlavor, зупинена черга чи перевірка допуску (admission check).
Наприклад, повідомлення стану може сповіщати, що Kueue не зміг призначити ResourceFlavor, оскільки ClusterQueue має недостатню квоту CPU. Таке повідомлення — перша справжня відповідь на запитання «Чому мій Job досі в черзі?». Решта шляху в Headlamp пояснює конфігурацію, що стоїть за цим.
Також перевірте розділ Events. Стани описують поточний стан; події допомагають побачити, що змінилося нещодавно або що Kueue намагався зробити.
Крок 3. Порівняйте запит Workload із його призначенням
Залишайтеся на сторінці подробиць Workload і перевірте PodSets та запити ресурсів. Втулок показує кількість Podʼів, CPU, памʼять та інші ресурси, які Kueue оцінює разом.
Це важливо, бо Job із parallelism: 3 та запитом один CPU на Pod просить у Kueue загалом три CPU. Погляд лише на шаблон одного Podʼа недооцінить Workload.
Якщо квоту вже зарезервовано, та сама сторінка також показує призначений ClusterQueue, ResourceFlavorʼи та використання допущених ресурсів. Якщо цих призначень допуску немає, Workload ще не дійшов до цього етапу.
У нашому прикладі Workload запитує:
- три Podʼи
- загалом три CPU
- загалом 600 MiB памʼяті
Наступне питання — куди цей запит потрапив у Kueue.
Крок 4. Перейдіть за посиланням на LocalQueue
Скористайтеся посиланням LocalQueue на сторінці подробиць Workload. LocalQueue — це точка входу на рівні простору імен, яку використовує Job. Вона зʼєднує Workloads у межах простору імен із ClusterQueue, що охоплює весь кластер.
Сторінка LocalQueue показує:
- її простір імен і підключений ClusterQueue
- політику зупинки (stop policy) та поточний статус
- кількість Workload в очікуванні, з резервуванням і допущених
- стани Kueue та події Kubernetes
- повʼязані Workloads у тому самому просторі імен
Ця сторінка відповідає на два практичні питання: чи потрапив Job до черги, яку ви очікували, і чи є він єдиним Workload в очікуванні там.
Якщо LocalQueue неактивний або зупинений, це може вже пояснювати очікування. Якщо він активний, перейдіть за посиланням на ClusterQueue, щоб перевірити ємність, що стоїть за ним.
Крок 5. Перевірте ємність і використання ClusterQueue
ClusterQueue представляє квоту та політику допуску на рівні кластера, доступні для одного чи кількох LocalQueue.
На його сторінці подробиць у Headlamp порівняйте запит Workload із такими параметрами:
- ресурси в межах квоти (covered resources)
- номінальна квота для кожного ResourceFlavor
- поточні резервування та використання
- обмеження запозичення та надання квоти
- кількість Workload в очікуванні, з резервуванням і допущених
- стратегія постановки в чергу (queueing strategy) та політика зупинки
- налаштування витіснення (preemption), чесного поділу (fair sharing), взаємозамінності flavor (flavor fungibility) та перевірок допуску
- стани Kueue та події Kubernetes
Для прикладу в цій статті ClusterQueue надає номінальну квоту в два CPU та два слоти Pod. Workload просить по три з кожного. Повідомлення стану та сторінка ClusterQueue тепер розповідають ту саму історію: Workload не вміщується, тож Kueue залишає Job призупиненим.
Це проблема ємності для допуску, а не доказ того, що kube-scheduler не зміг знайти вузол.
Крок 6. За потреби перевірте ResourceFlavor і Cohort
Квота не завжди є єдиним пулом. ResourceFlavor може представляти клас обчислень за допомогою міток вузлів, taints, tolerations або налаштувань топології. Скористайтеся посиланням на ResourceFlavor із ClusterQueue, коли стан згадує призначення flavor або коли Workload потребує певного класу обладнання, як-от вузли з GPU.
Якщо ClusterQueue належить Cohort, перейдіть і за цим посиланням. Cohort дає змогу ClusterQueue ділитися невикористаною квотою. Сторінка в Headlamp показує батьківські та дочірні Cohort, ClusterQueue-учасники, задіяні ResourceFlavorʼи, групи ресурсів, обмеження запозичення та надання квоти, а також відомості про чесний поділ.
Ці сторінки допомагають відповісти на більш тонке питання: чи заблоковано Workload тому, що черга не має власної квоти, тому, що вона не може позичити достатньо, чи тому, що не можна призначити придатний flavor?
Чого ми навчилися, не залишаючи Headlamp
Для прикладу Job в очікуванні інтерфейс дає нам повне пояснення:
- Workload не допущено.
- Його стан
QuotaReservedмає значення false, а повідомлення вказує на недостатню квоту. - Workload запитує три CPU та три слоти Pod.
- Його LocalQueue активний і вказує на очікуваний ClusterQueue.
- ClusterQueue надає лише два CPU та два слоти Pod.
- Тому Kueue тримає Job призупиненим, доки квота не стане доступною або конфігурацію черги не змінять.
Важлива не та обставина, що Headlamp вигадує новий статус. Він зчитує ті самі обʼєкти API Kubernetes, що й інші клієнти, а потім збирає повʼязані ресурси та зрозумілі значення в одному цілісному розслідуванні.
Якщо Workload допущено — перемикайтеся на інші режими
Уявімо, що сторінка подробиць Workload показує Admitted=True, але застосунок досі не працює. Kueue завершив свою частину рішення. Продовжуйте в стандартних режимах перегляду Kubernetes у Headlamp:
- Відкрийте Workloads → Jobs і перевірте стан та події Job.
- Відкрийте Workloads → Pods і фільтруйте за назвою Job або простором імен.
- Виберіть Pod у стані
Pendingі прочитайте його розділ Events.
На цьому етапі шукайте ознаки проблем планувальника, як-от недостатня ємність вузла, спорідненість вузлів (node affinity), taints і tolerations, обмеження топології, привʼязування постійних томів чи помилки завантаження образів.
Це перемикання — найкорисніше правило усунення несправностей у статті:
- Не допущено: розслідуйте ресурси Kueue в Headlamp.
Admitted, але Podʼи в станіPending: розслідуйте відомості про Job, Podʼи, вузли та планувальник у Headlamp.
Повторюваний чекліст Headlamp
Коли наступний Job не запускається, скористайтеся цим коротким шляхом:
- Відкрийте Kueue → Workloads і виберіть правильний простір імен.
- Знайдіть Workload, повʼязаний із Job.
- Перевірте зрозумілий поточний статус, а також стани
AdmittedіQuotaReserved. - Прочитайте повідомлення стану та нещодавні події.
- Порівняйте запити ресурсів PodSet із призначеннями допуску.
- Перейдіть за посиланням LocalQueue та підтвердьте його статус і ClusterQueue.
- Перейдіть за посиланням ClusterQueue і порівняйте квоту, резервування, використання та політику.
- Перевірте подробиці ResourceFlavor або Cohort, коли повідомлення вказує на вибір flavor або спільну квоту.
- Якщо допущено, перейдіть до режимів перегляду Job і Pod у Headlamp.
Що Headlamp замінює під час цього розслідування
Втулок не замінює kubectl чи kueuectl для скриптів, точного виведення обʼєктів чи змін. Він замінює монотонну навігацію без інтерфейсу, потрібну під час інтерактивного розслідування.
| Питання | Шлях у Headlamp | Еквівалент у командному рядку |
|---|---|---|
| Чи допущено Workload? | Kueue → Workloads → статус і стани | kubectl describe workload <workload-name> -n <namespace> |
| До якого LocalQueue він потрапив? | Workload → повʼязаний LocalQueue | kubectl get localqueue <localqueue-name> -n <namespace> -o yaml |
| Який ClusterQueue надає квоту? | LocalQueue → повʼязаний ClusterQueue | kubectl get clusterqueue <clusterqueue-name> -o yaml |
| Який flavor чи спільна квота мають значення? | ClusterQueue → ResourceFlavor або Cohort | kubectl get resourceflavor <flavor-name> -o yaml або kubectl get cohort <cohort-name> -o yaml |
| Що сталося після допуску? | Workloads → Jobs і Pods → події | kubectl describe job <job-name> -n <namespace> або kubectl describe pod <pod-name> -n <namespace> |
Для скриптів і робочих процесів GitOps командний рядок залишається правильним інструментом. Для людини, яка запитує «чому це очікує?», зазвичай швидше прочитати звʼязний шлях у Headlamp.
Необовʼязково: відтворіть сценарій очікування
Репозиторій втулка містить приклади маніфестів Cohort, ClusterQueue, LocalQueue, ResourceFlavor і Job для локального тестування. Застосуйте ці приклади до кластера зі встановленим Kueue, а потім відкрийте розділ Kueue в Headlamp.
Щоб відтворити конкретну невідповідність квоти, використану в цій статті, налаштуйте ClusterQueue з двома CPU та двома слотами Pod, а потім подайте Job із трьома Podʼами, що запитує один CPU на Pod. Job потрапляє до свого LocalQueue, Kueue створює Workload, і Workload залишається в очікуванні, бо сукупний запит більший за доступну квоту.
Цей сценарій навмисно винесено за межі основного огляду: щойно ресурси створено, саме розслідування слід вести в Headlamp.
Поточні обмеження альфа-версії
Випуск 0.1.0-alpha — це початковий режим перегляду шляху допуску Kueue лише для читання.
- Втулок не додає власних процесів створення, редагування, призупинення, відновлення чи видалення.
- Посилання на власника Workload показуються як текст і поки не є посиланнями.
- Інтерфейс залежить від дозволів Kubernetes облікового запису, який використовує Headlamp.
- Метрики та візуальна мапа взаємозвʼязків — можливі напрями подальшої роботи, а не можливості цього випуску.
Ці обмеження корисно висловити чітко: поточна мета втулка — зробити стан допуску та взаємозвʼязки ресурсів простішими для перевірки.
Розроблено в межах наставництва LFX
Втулок розроблено в межах наставництва CNCF LFX 2026 Term 2 з використанням TypeScript, React, API Kubernetes та системи втулків Headlamp.
Utkarsh Raj реалізував втулок за наставництва та рецензування René Dudfield (@illume) і Kevin Hannon (@kannon92). Відгуки спільнот Headlamp і Kueue сформували режими перегляду ресурсів, подання статусу, навігацію, документацію, тести та перший альфа-випуск.
Спробуйте та поділіться відгуками
Перегляньте сирці втулка та README, прочитайте документацію до випуску 0.1.0-alpha або поділіться відгуками в тікеті випуску.
Якщо Workload в очікуванні досі важко пояснити після проходження шляху в Headlamp, саме такий відгук допоможе покращити втулок.
Kubernetes v1.37: Представляємо стани життєвого циклу вузла
Kubernetes має багато способів описати те, що відбувається на вузлі. Готовність (readiness), taints, стан Podʼів, мітки, анотації та API конкретних провайдерів — кожен розкриває частину картини. Бракувало спільного способу, що належить Kubernetes, повідомити, що для вузла виконується drain, що він перебуває на обслуговуванні або що на ньому триває коректне вимкнення вузла.
Kubernetes v1.37 вводить пʼять загальновідомих станів вузла (Node conditions), що надають цей опис:
DrainInProgressDrainedMaintenancePlannedMaintenanceInProgressGracefulNodeShutdownInProgress
Нові стани життєвого циклу вузла
| Стан | Що він повідомляє |
|---|---|
DrainInProgress |
Для вузла активно виконується drain відповідно до обраних адміністратором критеріїв drain. |
Drained |
Вузол досяг обраних адміністратором критеріїв drain. |
MaintenancePlanned |
Очікується, що вузол пройде через зміну в майбутньому. |
MaintenanceInProgress |
Вузол перебуває в стані обслуговування. |
GracefulNodeShutdownInProgress |
Визначено, що на вузлі триває коректне вимкнення вузла. |
Обслуговування може включати оновлення апаратного або програмного забезпечення, виправлення, виведення з експлуатації або налагодження. Чи потребує обслуговування drain, залежить від його впливу. Оновлення Kubernetes зазвичай слід виконувати після drain, тоді як live patch ядра може не потребувати його.
Як і інші стани вузла, кожен стан життєвого циклу використовує status для повідомлення про те, чи активне спостереження:
True: стан життєвого циклу зараз спостерігається.False: стан життєвого циклу зараз не спостерігається.Unknown: Kubernetes не може визначити, чи активний стан життєвого циклу.
reason надає стабільну, машиночитану причину для поточного статусу, а message може надати додаткові людиночитані деталі.
Наприклад, авторизований контролер обслуговування може опублікувати:
# Node .status excerpt
status:
  conditions:
  - type: MaintenancePlanned
    status: "True"
    reason: MaintenanceWindow
    lastTransitionTime: "2026-12-09T12:00:00Z"
    message: "Hardware maintenance is scheduled for this Node"
Що змінюється в Kubernetes v1.37
У версії v1.37 ці імена зарезервовано як загальновідомі константи NodeConditionType, а також запроваджено функціональну можливість Alpha-рівня NodeLifecycleConditions, яка типово вимкнена. У версії 1.37 ця функціональна можливість фактично нічого не робить: вона не обмежує коло користувачів, які можуть встановлювати ці стани, і жоден основний компонент їх не зчитує. Вона існує для того, щоб у майбутніх версіях можна було увімкнути заплановану вбудовану поведінку — контролери, які використовують ці стани. Вам не потрібно вмикати цю функціональну можливість, щоб почати публікувати стани вже сьогодні.
У цьому випуску за встановлення та скидання станів життєвого циклу відповідає адміністратор або авторизований адміністратором контролер.
У цьому першому випуску жоден основний контролер робочих навантажень не змінює свою поведінку на основі цих станів, але адміністратор може публікувати їх щоб повідомляти користувачам кластера про обслуговування та drain.
Як використовувати стани життєвого циклу сьогодні
Безпосередньою перевагою є чіткість операційних процесів. Адміністратори та системи автоматизації життєвого циклу можуть використовувати ці стани як загальний канал статусу для роботи з життєвим циклом вузлів, яка вже здійснюється сьогодні.
Наприклад, автоматизація обслуговування може встановити MaintenancePlanned, коли заплановане майбутнє вікно обслуговування, потім встановити MaintenanceInProgress, коли робота починається. Автоматизація drain може встановити DrainInProgress, коли починає виселяти Podʼи, і Drained, коли обрані адміністратором критерії drain виконано. Стан GracefulNodeShutdownInProgress може повідомляти, що на вузлі триває коректне вимкнення вузла.
Рекомендований шаблон — використовувати стани життєвого циклу для повідомлення статусу, тоді як операції життєвого циклу керуються через інші механізми. Продовжуйте використовувати наявні механізми Kubernetes, такі як kubectl cordon, kubectl drain,
taints та специфічні для робочих навантажень механізми для зміни поведінки планування або виселення. Використовуйте стани життєвого циклу, щоб зробити статус цієї роботи видимим для людей, дашбордів, алертів та автоматизації, яка може використовувати цей сигнал.
Встановлюючи стан, використовуйте True, поки стан життєвого циклу активний. Встановіть стан у False або видаліть його, коли стан більше не активний. Використовуйте стабільне значення reason та зрозуміле message, щоб і люди, і автоматизація могли зрозуміти, чому стан змінився. Адміністратори кластера також повинні вирішити, який компонент володіє кожним станом життєвого циклу, щоб уникнути конфліктних записів.
Чому спільний сигнал важливий
Життєвий цикл вузла впливає на компоненти по всьому кластеру. kubelet, контролер життєвого циклу вузла, контролери робочих навантажень, планувальник, засоби автоматичного масштабування, оператори сховища, та зовнішні системи обслуговування — всі потребують певного розуміння того, що відбувається з вузлом.
Сьогодні кожен компонент має реконструювати це розуміння з непрямих сигналів. Один контролер може дивитися на готовність вузла, інший — на taints, третій — на Podʼи, що завершуються або відсутні. Провайдери інфраструктури та оператори часто додають власні мітки або анотації.
Ці сигнали залишаються корисними для своїх передбачених цілей, але вони не дають відповіді на те саме питання. Наприклад, taint може впливати на планування або виселення, але не свідчить про те, що триває drain або що критерії drain адміністратора виконано. Статус вузла NotReady не пояснює, чи причиною є несподівана несправність, коректне вимкнення чи планове технічне обслуговування.
Без спільного контексту життєвого циклу компоненти, які окремо є коректними, можуть приймати суперечливі рішення. Контролер DaemonSet може замінити Pod, який kubelet навмисно завершив під час коректного вимкнення. Контролер Job може безкінечно чекати на кінцеву фазу Podʼа на вузлі, який адміністратор видаляє. Оператор системи зберігання даних може дізнатися про технічне обслуговування лише після того, як drain уже розпочався.
Нові стани надають стабільне місце на вузлі для цього відсутнього контексту як частину більших зусиль щодо покращення керування життєвим циклом вузла.
Фундамент для Kubernetes, що враховує життєвий цикл
Цінність спільного сигналу полягає в тому, хто може його використовувати — основні контролери, адміністратори або екосистема проєктів життєвого циклу. Подальші вдосконалення можуть ґрунтуватися на цих станах, без необхідності для кожного компонента розробляти власний спосіб визначення стану життєвого циклу вузла.
Розгляньмо давній граничний випадок під час rollout DaemonSet. Вузол, який зламаний або перебуває на обслуговуванні, може залишатися недоступним з причин, не повʼязаних з новою ревізією DaemonSet. Цей вузол все ще споживає бюджет доступності rollout, що може сповільнити контролер або завадити йому просувати rollout на справних вузлах.
Контролер DaemonSet знає, що Pod недоступний, але він не може сказати, чи нова ревізія провалилася чи адміністратор навмисно вивів вузол з експлуатації. Готовність, taints та стан Podʼів показують частини ситуації, але жоден не надає авторитетного контексту обслуговування.
Стан MaintenanceInProgress створює власне Kubernetes місце для публікації цього контексту. Майбутня робота може визначити, як контролер DaemonSet використовує його для порядку розгортання, обліку доступності та повідомлення статусу. Ці поведінки все ще вимагають ретельного дизайну, але мета — щоб адміністраторам більше не потрібно було вручну коригувати розгортання.
Майбутні розширення та як долучитись
Життєвий цикл вузла — це перехресна проблема. Її розвʼязання починається з того, що компоненти обмінюються достатнім контекстом для прийняття сумісних рішень. Наступний етап — спиратися на Node Lifecycle Conditions для покращення таких сценаріїв, як Graceful Node Shutdown, drain та обслуговування. Довгострокова координація життєвого циклу може вимагати явної власності, блокування та потенційно спеціалізованого API.
Екосистема Kubernetes вже включає багато рішень для обслуговування вузлів, виправлення, drain, автоматичного масштабування та керування парком вузлів. Досвід цих проєктів необхідний для побудови фундаменту, що працює в різних середовищах та операційних моделях. Node Lifecycle Working Group, SIG Node та SIG Apps запрошують супровідників та користувачів поділитися своїми випадками використання та ідеями для формування майбутньої роботи.
Слідкуйте за роботою через KEP-5683: Node Lifecycle Conditions. Для участі в наших обговореннях, приєднуйтесь до однієї з наших груп:
Kubernetes v1.37: Storage Version Migration типово увімкнена
Я радий, що міграція версії зберігання (SVM) досягла загальної доступності (GA) у Kubernetes v1.37!
Після кількох випусків роботи та тестування вбудований API StorageVersionMigration (storagemigration.k8s.io/v1)
та контролер панелі управління тепер повністю стабільні та типово увімкнені у всіх кластерах Kubernetes v1.37.
Проблема застарілих версій зберігання
У Kubernetes збережені API-ресурси записуються з використанням певної версії зберігання (представлення схеми). Те, як Kubernetes взаємодіє з обʼєктним сховищем, принципово вимагає зміни ресурсу, щоб гарантувати використання останньої версії зберігання для всіх ресурсів. Це створює проблеми, коли ви хочете змінити версію зберігання ресурсу.
Один із прикладів сценарію, коли ви можете захотіти змінити версію зберігання ресурсу, — це коли ви просуваєте CRD, щоб відмовитися від старішої версії API (наприклад, v1alpha1) на користь новішої (залишивши лише v1beta1 та v1). Відмова від старішої версії API є проблемою, поки в сховищі все ще залишаються ресурси, збережені зі старою альфа-версією.
Щоб уникнути проблем, ви призначаєте v1 як нову версію зберігання; але само по собі цього недостатньо. Поки нові записи зберігаються як v1, будь-який наявний ресурс може залишатися збереженим як v1alpha1 або v1beta1 у сховищі. Ви не можете безпечно видалити v1alpha1 з .status.storedVersions CRD або припинити підтримку обслуговування, доки кожен окремий ресурс у сховищі не буде переписаний так, щоб не серіалізуватися та не зберігатися з альфа-версією.
Іншим доречним прикладом є шифрування у стані спокою та, повʼязана з ним, ротація ключів. Коли ви налаштовуєте шифрування у стані спокою або виконуєте ротацію ключів шифрування, наявні ресурси у сховищі залишаються незашифрованими (або зашифрованими старими ключами), доки вони не будуть активно переписані через API-сервер Kubernetes.
Історично адміністратори кластерів та автори CRD мали покладатися на ручні скрипти kubectl get / kubectl replace або розгортати зовнішній компонент kube-storage-version-migrator, щоб примусово виконувати перезапис. Ці підходи часто були марудними, схильними до помилок та важкими для моніторингу.
Як працює міграція версії зберігання
Запустити міграцію версії зберігання так само просто, як створити декларативний обʼєкт StorageVersionMigration. Вбудований контролер StorageVersionMigrator у панелі управління Kubernetes відстежує ці обʼєкти та автоматично переносить наявні ресурси до типової версії зберігання для цього API.
Приклад: міграція API власного ресурсу
Припустимо, ви оновили CustomResourceDefinition (crontabs.example.com), щоб використовувати v1 як версію зберігання. Щоб мігрувати всі наявні збережені ресурси зі старіших версій, створіть StorageVersionMigration:
apiVersion: storagemigration.k8s.io/v1
kind: StorageVersionMigration
metadata:
  name: crontabs-migration
spec:
  resource:
    group: example.com
    resource: crontabs
Застосуйте маніфест за допомогою kubectl:
kubectl apply -f crontabs-migration.yaml
Моніторинг та перевірка міграцій
Контролер StorageVersionMigrator оновлює status обʼєкта StorageVersionMigration у міру виконання міграції. Ви можете переглянути стан міграції за допомогою kubectl:
kubectl get storageversionmigration.storagemigration.k8s.io/crontabs-migration -o yaml
Успішна міграція повідомить про умову Succeeded зі значенням True:
status:
  conditions:
    - type: Running
      status: "False"
      lastUpdateTime: "2026-08-02T10:05:00Z"
      reason: StorageVersionMigrationInProgress
    - type: Succeeded
      status: "True"
      lastUpdateTime: "2026-08-02T10:05:00Z"
      reason: StorageVersionMigrationSucceeded
Після успішної міграції ви можете бути впевнені, що всі екземпляри ресурсу у сховищі збережені у поточній версії зберігання. Для CRD версія зберігання має бути оновлена в .status.storedVersions CRD так, щоб містити лише бажану версію. Якщо .status.storedVersions не оновлено після успішної міграції, це означає, що CRD було оновлено під час міграції. У цьому випадку міграцію слід повторити, щоб безпечно визнати старішу версію зберігання застарілою.
Включення міграцій у ваші маніфести CRD
Оскільки StorageVersionMigration — це стандартний декларативний API Kubernetes, автори CRD можуть постачати або запускати міграції безпосередньо разом з оновленнями CRD. Наприклад, ви можете включити міграцію в той самий маніфест, що й оновлений CustomResourceDefinition:
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
  name: crontabs.example.com
spec:
  group: example.com
  # Оновлений список версій, де v1 має storage: true
  ...
---
apiVersion: storagemigration.k8s.io/v1
kind: StorageVersionMigration
metadata:
  name: crontabs-migration
spec:
  resource:
    group: example.com
    resource: crontabs
Що далі?
- Дізнайтеся більше про концепції, що стоять за версіями зберігання.
- Прочитайте покроковий посібник: міграція обʼєктів Kubernetes з використанням міграції версії зберігання.
SIG API Machinery буде рада почути ваш відгук, коли ви впроваджуватимете вбудовану міграцію версії зберігання у своїх кластерах. Звертайтеся до нас на каналі #sig-api-machinery у Slack або беріть участь у наших обговореннях у спільноті!
Kubernetes v1.37: Garhwal
Редактори: Arsh Sharma, Christopher Tineo, Kirti Goyal, Sophia Ugochukwu, Swathi Rao, Troy Connor
Подібно до попередніх випусків, реліз Kubernetes v1.37 представляє нові стабільні, бета- та альфа-функції. Постійний випуск високоякісних версій підкреслює силу нашого циклу розробки та активну підтримку з боку нашої спільноти.
Цей випуск складається з 67 вдосконалень. З них 16 стали стабільними, 23 переходять у бета-версію, 27 стали альфа-функціями, а 1 функція визнана застарілою.
Тема та логотип релізу
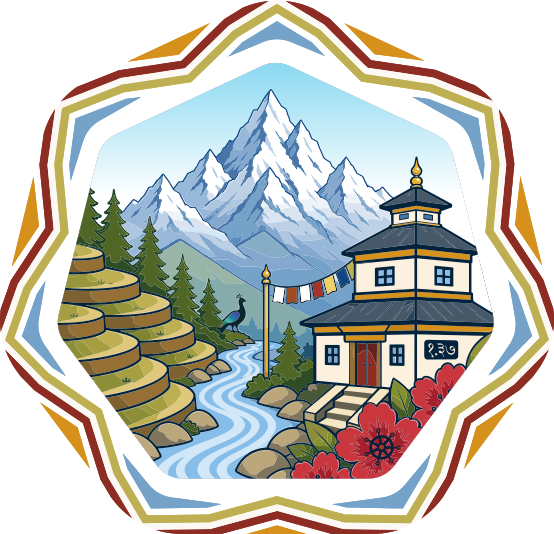
Темою для Kubernetes v1.37 є Гарвал (गढ़वाल, вимовляється як gaṛhvāl) — гімалайський регіон штату Уттаракханд, Індія. Засніжені вершини Гімалаїв у Гарвалі, ліси деодара, терасові поля, річки та струмки, а також гірські стежки формують як сам регіон, так і логотип. Усі ці елементи разом відображають спільноту, в якій кожен шар, кожен шлях і кожен внесок пов’язані між собою.
Логотип уявляється як вікно в пейзаж Гарвалу.1 Всередині терасові поля піднімаються до засніжених вершин, кожен рівень підтримується тим, що нижче, так само як кожен випуск Kubernetes залежить від роботи, виконаної раніше. Річка звивається долиною і збирає гірські потоки, відображаючи внески багатьох SIG та спільнот, що об’єднуються в один проєкт.
Деодаровий ліс — це ширша екосистема Kubernetes, де різні проєкти ділять спільну основу та ростуть пліч-о-пліч. Камʼяна кладка та деревʼяні конструкції формують стежку та гірський будинок, ставлячи людей у центр і викликаючи спільні основи, підтримувані для тих, хто йде слідом. Над річкою барвисті прапори ловлять вітер і оживляють сцену.
Сцену оточує фігурний каркас, натхненний кошикарством із рингаала — гнучкого карликового гімалайського бамбука. Окремі смужки набувають міцності, коли їх переплітають, так само як код, ревізії, тести, документація та координація об’єднуються для створення релізу.
У рамці зображений гімалайський монал — державний птах штату Уттаракханд, який мешкає на великих висотах у Гімалаях. Його райдужне пірʼя має безліч кольорів одночасно, подібно до того, як спільнота Kubernetes об’єднує різноманітні навички та погляди в одному проєкті. Квіти червоного буранша (Rhododendron arboreum), державного дерева штату Уттаракханд, мають у центрі символи Kubernetes, поєднуючи знайомий цвіт Гархвала із символом, який поділяє спільнота. На будинку зображено数字 १.३७ (1,37 у цифрах деванагарі), що вкорінює цей реліз у місцевий ландшафт.
1. Продовжуйте дивитися у вікно (логотип). Спостерігайте, як тече річка і як прапори майоріють на вітрі. За 37 секунд пейзаж відкриє свою магію.. 😉
Основні оновлення
Kubernetes v1.37 насичений новими функціями та покращеннями. Ось кілька оновлень, які Команда випуску хотіла б виділити!
Stable: Стійка ініціалізація watchcache
Kubernetes v1.37 завершує роботу над стійкою ініціалізацією watchcache: функціональна можливість ResilientWatchCacheInitialization досягла стану Stable ще в v1.34, а в v1.37 інша функціональна можливість WatchCacheInitializationPostStartHook переходить у Stable і заблокована. З v1.36 вона стандартно увімкнена, що посилює API-сервер при старті та під час відновлення. Ініціалізація та повторна ініціалізація watchcache більше не створюють стрибка трафіку запитів до etcd, а запити обробляються коректно замість накопичення під час прогрівання кешу.
Щоб уникнути надмірного навантаження etcd або вичерпання можливостей механізмів API Priority та Fairness через дорогі запити типу «list» та «watch», kube-apiserver тепер безпечно делегує запити з обмеженим обсягом, а інші відхиляє, повертаючи відповіді HTTP 429. Це знижує ризик відмови панелі управління у великих кластерах. Клієнти (включно з власними контролерами та операторами) мають коректно обробляти відповіді HTTP 429 Too Many Requests, дотримуючись заголовків Retry-After та використовуючи експоненційну затримку.
Ця робота була виконана як частина KEP #4568 під керівництвом SIG API Machinery.
Beta: Масштабування HorizontalPodAutoscaler до нуля
У Kubernetes v1.37 підтримка масштабування до нуля для HorizontalPodAutoscaler переходить у Beta. Вперше представлена в Kubernetes v1.16, вона тепер стандартно увімкнена.
Для робочих навантажень, що використовують метрики обʼєктів або зовнішні метрики, ця функція дозволяє HorizontalPodAutoscaler масштабуватися до нуля Podʼів у стані простою, а потім відновлювати їх, коли попит повертається. Це може знизити витрати для обробників черг, пакетних завдань та навантажень з GPU.
Масштабування до нуля на основі метрик CPU та памʼяті не підтримується, оскільки ці метрики залежать від активних Podʼів. Натомість ця функція призначена для сценаріїв, коли кількість реплік залишається нульовою, доки не зʼявиться робота в черзі для обробки.
Поки HorizontalPodAutoscaler утримує робоче навантаження з нульовою кількістю реплік, він фіксує стан ScaledToZero зі значенням True у статусі HorizontalPodAutoscaler. Контролер HorizontalPodAutoscaler потім використовує цей стан, щоб відрізнити робоче навантаження, яке він масштабував до нуля (і яке масштабується назад, коли показник повертається), від робочого навантаження, яке було вручну деактивоване встановленням кількості реплік у 0. Коли робоче навантаження масштабується назад, стан встановлюється у False з причиною NotScaledToZero.
Ця робота була виконана як частина KEP #2021 під керівництвом SIG Autoscaling.
Beta: Конфігурація контролю допусків на основі маніфестів
Kubernetes v1.37 переводить конфігурацію контролю допусків на основі маніфестів у Beta. Admission webhooks та політики на основі CEL тепер можуть завантажуватися з маніфестів на диску через поле staticManifestsDir у AdmissionConfiguration, замість того, щоб існувати лише в Kubernetes API. Політики, завантажені таким чином, застосовуються з моменту запуску сервера API, продовжують діяти навіть під час недоступності etcd і можуть захищати самі ресурси допуску на основі API від модифікації.
Ця робота була виконана як частина KEP #5793 під керівництвом SIG API Machinery.
Alpha: Контрольна точка та відновлення на рівні Podʼів
Kubernetes v1.37 представляє підтримку Alpha для контрольних точок та відновлення на рівні Podʼів, розширюючи CRI за допомогою RPC CheckpointPod та RestorePod, які дозволяють kubelet та сумісним рушіям виконання контейнерів створювати контрольну точку Podʼа та відновлювати Podʼа з неї. Щоб використати цю функцію, середовище виконання контейнерів також має реалізувати ці нові RPC.
Ця робота була виконана як частина KEP #5823 під керівництвом SIG Node.
Функції, що переходять у стабільний стан
Цей розділ перераховує всі функції, що перейшли в Stable (також відомий як стан загальної доступності (GA, General Availability)). Для повного списку оновлень, включаючи нові функції та переходи з Alpha в Beta, дивіться примітки до випуску.
Цей випуск включає загалом 16 вдосконалень, переведених у Stable:
KYAML
KYAML — це безпечніша та менш неоднозначна підмножина YAML, розроблена спеціально для Kubernetes, а не заміна для нього. Кожен файл KYAML є валідним YAML, тож KYAML є валідним вхідним форматом для будь-якої версії kubectl, а файли специфікацій не потрібно писати саме в KYAML, щоб їх можна було обробити. Ваші наявні маніфести, інструменти та конвеєри не потребують змін. KYAML вперше представлений як альфа-функція у v1.34 і перейшов у бета-версію в v1.35. KYAML переходить у стабільний стан у v1.37 після завершення тестування на відповідність, і команда kubectl get -o kyaml тепер також є стабільною.
Щоб дізнатися більше про KYAML, перегляньте допис «Як форматувати ваш Kubernetes YAML у форматі KYAML і навіщо це потрібно».
Ця робота була виконана як частина KEP #5295 під керівництвом SIG CLI.
API metrics.k8s.io
API metrics.k8s.io переходить у Stable в Kubernetes v1.37 після майже девʼяти років у Beta. API надає стандартний спосіб отримання відомостей про використання CPU та памʼяті для podʼів та вузлів, живлячи широко використовувані функції Kubernetes такі як HorizontalPodAutoscaler (HPA) та команди на кшталт kubectl top.
Перехід відповідає цілі проєкту Kubernetes уникати постійних API у Beta. Тепер, коли v1 існує, майбутні випуски Kubernetes перейдуть на нього; v1beta1 залишається придатним для використання протягом переходу, відповідно до політики застарівання API, тому ви можете прийняти Stable API, не ламаючи існуючі робочі процеси.
Ця робота була виконана як частина KEP #5207 під керівництвом SIG Instrumentation.
SELinuxMount та SELinuxChangePolicy
У Kubernetes v1.37 прапорці SELinuxMount та SELinuxChangePolicy переходять у Stable і стандартно ввімкнені: це означає, що томи монтуються з -o context=<label> (типово MountOption) замість рекурсивного перейменування, але лише коли CSI драйвер тому обирає через .spec.seLinuxMount: true для обʼєкта CSIDriver.
Монтування може нести лише один контекст SELinux, тому Podʼи з різними мітками SELinux, що разом використовують том на одному вузлі, які раніше співіснували під час рекурсивного перейменування, тепер можуть не запуститися. Щоб зберегти стару поведінку для роботи, рекомендується встановити .spec.seLinuxChangePolicy у Recursive для Pod.
Ця поведінка сама по собі не заблокована до v1.38, тому відключення її на рівні кластера залишається варіантом на ще один випуск. Кластери без увімкненого SELinux не відчувають жодного ефекту. Щоб дізнатися більше, перегляньте Зміни міток томів SELinux переходять у GA (і ймовірні наслідки в v1.37).
Ця робота була виконана як частина KEP #1710 під керівництвом SIG Storage.
Функції DRA, що переходять у стабільний стан
DRA: Статус ResourceClaim з можливими стандартизованими даними мережевого інтерфейсу
Статус .status.devices ResourceClaim переходить у Stable в Kubernetes v1.37, що дозволяє драйверам повідомляти специфічні для пристрою дані статусу для кожного виділеного пристрою в заявці на ресурс. Це полегшує розуміння того, як налаштовано пристрій, усунення несправностей та використання пристрою разом з іншими сервісами.
Це особливо корисно для мережевих пристроїв; до додавання цього поля, якщо Pod запитував мережевий пристрій через DRA, жоден інший компонент системи не мав можливості дізнатися IP-адресу, присвоєну цьому мережевому пристрою. Нове поле стану забезпечує стандартизований спосіб, за допомогою якого драйвер DRA може передавати цю інформацію компонентам, які її потребують, що робить DRA повністю придатним для підключення додаткових мережевих інтерфейсів до Podів.
Ця робота була виконана як частина KEP #4817 під керівництвом SIG Node та SIG Network.
DRA: обробка запитів розширених ресурсів через драйвер DRA
Підтримка розширених ресурсів DRA переходить у Stable в Kubernetes v1.37. Ця функція дозволяє драйверам DRA задовольняти запити, зроблені через традиційний механізм розширених ресурсів, наприклад abc.example/gpu: 3 у специфікації Podʼа, без необхідності окремого втулка пристрою.
За допомогою цього механізму імʼя розширеного ресурсу може бути призначене безпосередньо DeviceClass. Podʼи, що запитують цей ресурс, можуть мати пристрій, виділений через DRA, без необхідності визначати ResourceClaim у робочому навантаженні.
Ця робота була виконана як частина KEP #5004 під керівництвом SIG Scheduling.
DRA: позначки taint та toleration пристроїв
Підтримка taints та tolerations для фізичних пристроїв, керованих через DRA, тепер є Stable в Kubernetes v1.37. Стандартно будь-який доступний пристрій може розглядатися для планування. Це вдосконалення надає більший контроль над плануванням пристроїв, дозволяючи драйверам DRA позначати конкретні пристрої позначкою taint, запобігаючи їхньому вибору для робочих навантажень. Крім того, адміністратори кластера можуть створити DeviceTaintRule для позначення пристроїв як taint на основі конкретних критеріїв відбору, наприклад, усіх пристроїв, керованих певним драйвером.
Ця робота була виконана як частина KEP #5055 під керівництвом SIG Scheduling.
DRA: стандартний атрибут пристрою numaNode
Kubernetes v1.37 визначає новий стандартний атрибут пристрою NUMA-вузла. Він стандартизує resource.kubernetes.io/numaNode як спільне імʼя атрибуту для інформації про NUMA-вузол пристрою, дозволяючи пристроям, керованим різними драйверами DRA, порівнюватися на основі одного й того ж NUMA-вузла. Це дозволяє уникати ситуації, коли кожен драйвер визначає власну назву атрибуту, і надає послідовний спосіб ідентифікації NUMA-розміщення між пристроями. Це вдосконалення одразу переходить у стабільний стан, оскільки це KEP щодо іменування та реєстрації без функціональної можливості чи змін поведінки в кодовій базі.
Ця робота була виконана як частина KEP #6072 під керівництвом SIG Node.
Функції, оголошені вузлом
Функції, оголошені вузлом переходять у Stable в Kubernetes v1.37, надаючи фреймворк для оголошення доступності конкретних, керованих функціональними можливостями функцій Kubernetes для вузлів. Ці функції потім використовуються компонентами панелі управління (такими як kube-scheduler, контролери допуску або сам API-сервер) для керування розбіжністю версій (version skew).
Функція вводить нове поле .status.declaredFeatures для вузлів, яке використовується для оголошення функції, що проходить через етапи Alpha → Beta → Stable. Панель управління може використовувати це поле для забезпечення правильної роботи навіть у кластері, де одночасно працюють вузли з різними версіями.
Коли функції переходять у Stable і панель управління може припустити, що всі вузли підтримують їх у межах вікна розбіжності версій, вузли припиняють повідомляти про них.
kubelet визначає свої оголошені функції при запуску, базуючись лише на функціональних можливостях та статичній конфігурації вузла (отже, будь-які зміни вимагають перезапуску kubelet).
Ця робота була виконана як частина KEP #5328 під керівництвом SIG Node.
Мігратор версій сховища
Kubernetes v1.37 переводить API StorageVersionMigration (storagemigration.k8s.io/v1) у Stable і стандартно його вмикає. Він допомагає виконувати мігрувацію наявних ресурсів, як вбудованих, так і власних ресурсів користувача, зі старішої версії сховища на нову після оновлення API, наприклад, коли бажана версія сховища змінюється з v1beta1 на v1. Його також можна використати для перезапису наявних даних після зміни шифрування у стані спокою, щоб застарілі дані зберігалися з новими налаштуваннями шифрування.
Історично адміністраторам кластерів та авторам CustomResourceDefinition доводилося використовувати ручні скрипти kubectl get або kubectl replace, або розгортати out-of-tree компонент kube-storage-version-migrator для переписування наявних ресурсів. Ці підходи часто були важкими, схильними до помилок і важкими для моніторингу.
Щоб розпочати міграцію версії сховища, користувачам потрібно створити декларативний обʼєкт StorageVersionMigration. Вбудований контролер StorageVersionMigrator у панелі управління Kubernetes слідкує за цими обʼєктами і виконує автоматичну міграцію наявних ресурсів до базової версії сховищення для цього API. Оскільки StorageVersionMigration є стандартним Kubernetes API, автори CRD можуть запускати міграції як частину оновлення CRD замість окремого керування міграцією.
Ця робота була виконана як частина KEP #4192 під керівництвом SIG API Machinery.
Stable: Сертифікати Podʼів та Cluster Trust Bundles
Сертифікати Podʼів та тісно повʼязані ClusterTrustBundles обидва переходять у Stable в Kubernetes v1.37, надаючи першокласну підтримку для розповсюдження приватних ключів, X.509 сертифікатів та пакунків довіри до Podʼів.
Щоб це використати, розробник або адміністратор обирає імʼя підписувача і розгортає контролер підписувача, який спостерігає за обʼєктами PodCertificateRequest, видає та оновлює сертифікати для придатних Podʼів і підтримує відповідні обʼєкти ClusterTrustBundles, що містять довірчі точки (trust anchors), необхідні для перевірки цих сертифікатів. Робоче навантаження потім підключається до цієї ідентичності, визначаючи проєкційний том podCertificate з обраним імʼям підписувача. Робочі навантаження також можуть монтувати проєкційний том ClusterTrustBundle для завантаження інформації про довірчі точки.
Ця робота була виконана як частина двох KEP — KEP #4317 та KEP #3257 під керівництвом SIG Auth.
Функції, що перейшли в Beta
Підтримка групового планування (Gang scheduling) в Kubernetes
Оскільки Kubernetes стає де-факто стандартом для керування AI/ML навантаженнями в масштабі, планування таких робіт, як тренування AI/ML моделей та HPC-симуляції, стає важливішим ніж будь-коли. Однак планування стає викликом, оскільки стандартний планувальник Kubernetes планує Podʼи індивідуально, що може призвести до того, що деякі Podʼи плануються, тоді як інші залишаються у стані очікування через нестачу ресурсів. Таке часткове планування може призвести до взаємних блокувань (deadlock) та неефективного використання ресурсів кластера.
Групове планування (Gang scheduling) переходить у Beta в Kubernetes v1.37, вдосконалюючи нативну підтримку групового планування через Workload API та концепцію PodGroup. Ця функція реалізує стратегію планування «все або нічого», забезпечуючи, що визначена група Podʼів планується лише тоді, коли кластер має достатньо ресурсів для розміщення всієї групи. Перехід у Beta також вводить планування з урахуванням навантаження (workload-aware preemption), щоб уникнути передчасних витіснень, які не допомагають навантаженню просуватись в роботі, а також чергування PodGroup для кращої координації конкуруючих навантажень.
Важливо, що це вирішує сценарії активного очікування (livelock), які можуть виникати, коли кілька навантажень плануються одночасно kube-schedulerʼом, запобігаючи їхньому взаємному блокуванню без прогресу.
Ця робота була виконана як частина KEP #4671 під керівництвом SIG Scheduling.
Нативна підтримка гістограм для метрик Kubernetes
Kubernetes експонує сотні метрик-гістограм у форматі Prometheus у компонентах панелі управління, які є необхідними для моніторингу стану кластера та відстеження проблем продуктивності. Однак класичні гістограми Prometheus покладалися на статичні, заздалегідь визначені кошики (buckets), що змушувало йти на компроміс між точністю даних та використанням памʼяті. Для помʼякшення цього Prometheus представив нативні гістограми, які використовують динамічні експоненційні межі кошиків замість фіксованих, забезпечуючи значну ефективність зберігання, покращену продуктивність запитів та детальнішу видимість розподілів, зберігаючи при цьому повну зворотну сумісність з наявною інфраструктурою моніторингу.
Kubernetes v1.37 переводить нативну підтримку гістограм для метрик Kubernetes у бета-версію. Базуючись на реалізації Alpha, яка ввела функціональну можливість NativeHistograms, фаза Beta покращує реалізацію та досвід розгортання. Коли увімкнено, компоненти Kubernetes експонують гістограми як у класичному, так і в нативному форматах, коли запитуваний протокол скрейпінгу підтримує Нативні Гістограми (зокрема PrometheusProto), дозволяючи наявним дашбордам та сповіщенням продовжувати працювати, поки користувачі виконують міграцію у власному темпі. Реалізація також переробила гістограми, створені в функціях init(), для використання лінивої ініціалізації, гарантуючи, що опції нативних гістограм правильно застосовуються після обробки функціональних можливостей. Ці зміни надають більш надійну реалізацію, зберігаючи при цьому безпечні розгортання та відкат через функціональну можливість або конфігурацію на стороні Prometheus для користувачів Prometheus 3.x.
Ця робота була виконана як частина KEP #5808 під керівництвом SIG Instrumentation.
WAS: Функції, що переходять у Beta
Витіснення з урахуванням навантаження
Традиційно Kubernetes виконує витіснення на рівні Podʼів, що може бути неефективним для навантажень, що складаються з кількох тісно повʼязаних Podʼів. У Kubernetes v1.37 витіснення з урахуванням навантаження (workload-aware preemption, WAP) переходить у Beta, дозволяючи планувальнику враховувати PodGroup при прийнятті рішень про витіснення. Це допомагає планувальнику розглядати навантаження як єдину сутність при витісненні навантажень нижчого пріоритету, зменшуючи випадки, коли індивідуальні Podʼи витісняються без забезпечення достатньої потужності для роботи корисного навантаження.
Ця робота була виконана як частина KEP #5710 під керівництвом SIG Scheduling.
DRA: Підтримка ResourceClaim для навантажень
Dynamic Resource Allocation (DRA) дозволяє Podʼам запитувати спеціалізовані ресурси через ResourceClaims. У Kubernetes v1.37 підтримка DRA ResourceClaims для навантажень переходить у Beta, дозволяючи Workload та PodGroup API асоціювати ResourceClaims та ResourceClaimTemplates з групами Podʼів. Це дозволяє ResourceClaims бути спільними для всього навантаження замість індивідуального резервування для кожного Podʼа, тоді як ResourceClaimTemplates можуть автоматично створювати claims для PodGroup.
Ця робота була виконана як частина KEP #5729 під керівництвом SIG Scheduling.
Статистика контейнерів та Podʼів без cAdvisor, повністю через CRI
kubelet історично отримував статистику контейнерів та Podʼів з cAdvisor, тоді як Container Runtime Interface (CRI) експонував власну статистику. Наявність двох джерел для однакових метрик ускладнює розуміння, звідки взялося конкретне значення.
У Kubernetes v1.37 покращення «статистика контейнерів та Podʼів без cAdvisor, повністю через CRI» переходить у Beta. Це покращення розширює CRI для надання статистики контейнерів та Podʼів, необхідної Kubernetes, дозволяючи kubelet отримувати ці метрики безпосередньо від рушія виконання контейнерів замість залежності від cAdvisor.
Це переміщує метрики контейнерів та Podʼів до єдиного джерела правди, одночасно зменшуючи дублювання збору метрик та спрощуючи те, як kubelet збирає та виставляє ці статистики.
Ця функція є Beta у v1.37, але стандартно вимкнена; увімкніть функціональну можливість PodAndContainerStatsFromCRI, щоб спробувати її.
Ця робота була виконана як частина KEP #2371 під керівництвом SIG Node.
Підтримка memory QoS з cgroups v2
Kubernetes покращує свої механізми якості обслуговування (QoS) для покриття захисту та ізоляції памʼяті для навантажень Kubernetes. Для вузлів, що працюють на Linux, функція memory QoS використовує запити та ліміти памʼяті для налаштування cgroup-контролів, які можуть захистити запитану памʼять від відновлення (reclamation) та обмежити (throttle) використання памʼяті до досягнення жорстких лімітів навантаженням. Це може допомогти зменшити вплив тиску памʼяті на чутливі до памʼяті навантаження та покращити стабільність вузла.
У Kubernetes v1.37 підтримка memory QoS переходить у Beta. Функція використовує cgroups v2 контролі памʼяті, такі як memory.min, memory.low та memory.high, для надання різних рівнів захисту памʼяті та обмеження. Наприклад, запити памʼяті можуть використовуватися для захисту памʼяті від відновлення, тоді як memory.high може використовуватися для обмеження навантажень, що перевищують свої налаштовані пороги.
Функціональна можливість MemoryQoS стандартно увімкнена у v1.37. Оператори кластерів можуть контролювати захист памʼяті через налаштування memoryReservationPolicy у kubelet та налаштовувати обмеження памʼяті за допомогою memoryThrottlingFactor. Типово вони розроблені так, щоб уникнути несподіваного обмеження памʼяті для існуючих навантажень при оновленні до v1.37, одночасно дозволяючи операторам підключитися до додаткових можливостей захисту памʼяті.
Ця робота була виконана як частина KEP #2570 під керівництвом SIG Node.
Менеджери ресурсів на рівні Podʼів
У Kubernetes v1.37 менеджери ресурсів на рівні Podʼів переходять у Beta з функціональною можливістю PodLevelResourceManagers, яка залишається стандартно вимкненою. Її увімкнення дозволяє менеджерам топології, CPU та памʼяті використовувати ресурси, визначені для всього Podʼа, при прийнятті рішень про виділення та NUMA-вирівнювання. Це робить можливим керування Podʼом як єдиною одиницею ресурсів, одночасно підтримуючи різні вимоги до ресурсів між контейнерами всередині нього.
З управлінням ресурсів на рівні Podʼа, Pod може резервувати NUMA-вирівняний пул CPU та памʼяті на основі свого загального ресурсного бюджету. Контейнери, що вимагають виділених ресурсів, можуть отримати ексклюзивні частини цього пулу, тоді як інші контейнери, такі як sidecar або підтримуючі навантаження, можуть спільно використовувати залишкові ресурси. Це особливо корисно для промислових чутливих навантажень, таких як AI/ML та HPC, де зберігання ресурсів близько один до одного на одному NUMA-вузлі може покращити продуктивність без вимоги, щоб кожен контейнер у Podʼі мав виділені ресурси.
Ця функція також підтримує область дії контейнера, в якій контейнери можуть і надалі отримувати незалежні виділення ресурсів, вирівняні за NUMA. Це забезпечує більшу гнучкість для робочих навантажень, що поєднують контейнер, чутливий до продуктивності, з іншими контейнерами, які мають інші вимоги до ресурсів.
Ця робота була виконана як частина KEP #5526 під керівництвом SIG Node.
Узгоддження контролера маршрутів на основі watch (Watch-based route controller reconciliation)
Контролер маршрутів у бібліотеці cloud-controller-manager раніше виконував узгодження маршрутів за фіксованим інтервалом, типово кожні 10 секунд. Це могло призводити до непотрібних запитів до провайдерів інфраструктури, навіть коли нічого не змінювалося, а також затримувати оновлення маршрутів при додаванні нового вузла.
Узгодження контролера маршрутів на основі watch перейшло в Beta в Kubernetes v1.37. Цей випуск також додає спостережуваність для цієї роботи: Alpha-метрика контролера маршрутів route_sync_total отримує дві мітки — trigger (periodic або node_change) та outcome (changed, noop або error), щоб оператори могли бачити, чи періодична реконсиляція дійсно виправляє дрифт маршрутів або просто працює як no-op, і відстежувати невдалі узгодження.
З узгодженням на основі watch, контролер маршрутів може узгоджувати маршрути з подій watch замість очікування наступного фіксованого інтервалу: узгодження може розпочатися негайно, коли відбуваються відповідні зміни вузла, такі як додавання або видалення вузла, або коли змінюються його адреси або призначені Pod CIDR. Менш часте періодичне узгодження все ще виконується для виявлення застарілих маршрутів та підтримки узгодженості стану. Ця поведінка знаходиться за функціональною можливістю CloudControllerManagerWatchBasedRoutesReconciliation і стандартно вимкнена, отже, перехід не змінив типову поведінку.
Це зменшує непотрібні запити до провайдерів інфраструктури, дозволяючи одночасно швидше узгоджувати маршрути для щойно доданих вузлів. Зміна не змінює логіку узгодження маршрутів саму по собі; вона змінює те, коли запускається узгодження.
Ця робота була виконана як частина KEP #5237 під керівництвом SIG Cloud Provider.
Оцінка ємності сховища вузлів
Втулок планувальника VolumeBinding завжди міг робити оцінку (scoring) вузлів для статично привʼязаних PV на основі вільної ємності, але ця оцінка ніколи не поширювалася на динамічне провизионування.
Коли CSI-драйвер провизионує новий том за запитом, планувальник не мав способу віддати перевагу вузлу з більшою або меншою вільною областю.
Це було прогалиною для локального сховища, оскільки адміністратор міг хотіти, щоб Podʼи потрапляли на вузол з найбільшою вільною ємністю, щоб залишити місце для пізнішого розширення тома, або на вузол з найменшою (але все ще достатньою) вільною ємністю, щоб упакувати навантаження щільніше (bin-pack) і зменшити кількість вузлів, необхідних для роботи хмарного кластера.
Kubernetes v1.37 переводить оцінювання ємності сховища для динамічного провізіонування у бета-версію за допомогою функціональної можливості StorageCapacityScoring. Її вперше представили в альфа-версії в v1.33, а ця функція обʼєднує й оголошує застарілою старішу функціональну можливість VolumeCapacityPriority з KEP #1845. Коли її увімкнено, точка розширення Score втулка VolumeBinding зчитує обʼєкти CSIStorageCapacity, опубліковані зовнішнім sidecar-контейнером провізіонера драйвера, й оцінює вузли для динамічного провізіонування так само, як уже робить для статичних привʼязок. Адміністратори обирають стратегію через параметр Shape у VolumeBindingArgs — типово це «надавати перевагу вузлу з максимальною доступною ємністю», щоб залишити простір для подальшого розширення.
Функція залежить виключно від функціональної можливості StorageCapacityScoring: оцінка для статично привʼязаних PV запускається одразу при увімкненні, незалежно від будь-якого CSI-драйвера. Драйверу потрібно лише StorageCapacity: true на своєму обʼєкті CSIDriver, щоб його динамічно надані томи також отримували оцінку з урахуванням ємності. Функція повністю зворотня, і вимкнення функціональної можливості зупиняє всю оцінку ємності VolumeBinding, як статичну, так і динамічну, без впливу на вже заплановані Podʼи.
Ця робота була виконана як частина KEP #4049 під керівництвом SIG Storage.
Інтеграція CSI лімітів підключення томів з Cluster Autoscaler
У Kubernetes v1.37 покращено інтеграцію Cluster Autoscaler з обмеженнями підключення томів CSI, завдяки чому під час створення нових вузлів для Podʼів, що очікують на обробку, Cluster Autoscaler може точніше визначити, скільки нових вузлів потрібно для підключення всіх Podʼів, що очікують на обробку та використовують томи CSI. Cluster Autoscaler вже мав доступ до інформації про обмеження підключення томів CSI для наявних вузлів, але не для вузлів, які він збирався створити, що означало: він міг недостатньо масштабувати систему і залишати Podʼи, що використовують томи, у стані очікування навіть після додавання ємності. Проблема ускладнюється з боку планування: втулок NodeVolumeLimits розглядає вузол без опублікованої інформації про драйвер CSI як такий, що не має жодних обмежень, тому щойно створений вузол, який ще не повідомив про свій об’єкт CSINode, може бути переповнений більшою кількістю Podʼів, підкріплених томами, ніж він фактично може підключити, що є конкурентною ситуацією, яку дотепер адміністратори кластерів не мали можливості усунути.
У версії Kubernetes v1.37 функція автоматичного масштабування з підтримкою CSI переходить у стадію бета-тестування з функціональною можливістю VolumeLimitScaling, яка вперше була представлена у версії v1.35 у стадії альфа-тестування. Cluster autoscaler тепер запускає симуляції масштабування вгору для шаблонних обʼєктів CSINode, щоб правильно враховувати ліміти підключення, чи то він масштабує наявну групу вузлів, чи створює її з нуля. З боку планувальника, адміністратори можуть підключитися на рівні CSIDriver, через нове поле PreventPodSchedulingIfMissing, щоб заблокувати розміщення Podʼів на вузлах, що ще не повідомили свій драйвер, з виділеними помилками CSIDriverMissingOnNode та CSINodeMissing, що роблять ці помилки планування легшими для відстеження. Фаза Beta додає наскрізне покриття для поведінки масштабування вниз та сценаріїв CSI opt-in, та оновлює метрики failed_scale_ups_total та scaled_up_nodes_total, щоб включати інформацію про CSI-драйвери. Зміни як в автомасштабувачі, так і в планувальнику залишаються суто опціональними: вимкнення функціональної можливості відновлює поточне стандартне значення — необмежене розміщення подів на вузлах без даних CSINode, тому дистрибутиви та адміністратори, які використовують автомасштабувачі, що ще не підтримують CSI (наприклад, Karpenter), не змушені переходити на нову модель роботи.
Ця робота була виконана як частина KEP #5030 під керівництвом SIG Autoscaling.
Звіт про час останнього використання PVC
PersistentVolumeClaims зазвичай живуть довше за навантаження, що їх створили. Коли застосунок видаляється або мігрує, його PVC залишається, споживаючи сховище та збільшуючи витрати. Сьогодні Kubernetes не дає адміністраторам кластерів жодного способу дізнатися, як довго PVC просидів бездіяльно; kubelet є єдиним компонентом, який дійсно знає, коли том був змонтований останній раз, але немає чогось що не виводить цю інформацію на рівні API, тому адміністратори залишаються вгадувати, які PVC насправді безпечні для очищення.
Kubernetes v1.37 переводить відстеження «останнього використання» PVC у Beta з функціональною можливістю PersistentVolumeClaimUnusedSinceTime, яка у Alpha (v1.36) була стандартно вимкнена, а тепер стандартно увімкнена. Функція додає новий стан Unused до PersistentVolumeClaimStatus, якою керує наявний контролер захисту PVC: Status=True (Reason=NoPodsUsingPVC) коли останній нетермінальний Pod, що посилається на PVC, зникає, і назад до Status=False (Reason=PodUsingPVC) якомога швидше, як тільки Pod починає посилатися на нього знову. lastTransitionTime цього стану використовується як позначка часу «невикористано з», тому адміністратори можуть запитати, та як довго PVC дійсно просидів бездіяльно, без того, щоб Kubernetes відстежував, який саме Pod використав його останнім, чи приймав будь-які рішення про видалення — це залишається повністю на розсуд адміністратора. Варто зазначити, що позначка часу відображає момент, коли контролер спостерігав відсутність Podʼів, що використовують PVC, а не точний момент розмонтування тома на рівні інфраструктури, тому повідомлений час бездіяльності може бути дещо меншим за справжній, але ніколи не перевищить його.
Ця робота була виконана як частина KEP #5541 під керівництвом SIG Storage.
Підтримка etcd RangeStream
Унарний RPC-виклик Range в etcd формує повну відповідь у пам’яті перед її відправкою, що стає проблемою при масштабуванні. У випадку великого списку, наприклад, під час розігріву кешу спостереження kube-apiserver у великому кластері, необроблений фрагмент «ключ-значення», його серіалізована форма protobuf та буфер відправки gRPC мають одночасно співіснувати в пам’яті, а внаслідок цього спалахи навантаження поширюються й на kube-apiserver. Разбиття на сторінки також не вирішує проблему базових витрат, оскільки кожна сторінка все одно проходить весь індекс B-дерева для обчислення загальної кількості результатів, перетворюючи операцію, яка мала б бути O(limit), на операцію O(total_keys) для кожної окремої сторінки.
У Kubernetes v1.37 підтримка etcd RangeStream надається безпосередньо у версії Beta, з функціональною можливістю EtcdRangeStream (лише для kube-apiserver, стандартно увімкнено). У цьому випуску додано новий RPC-інтерфейс RangeStream для потокової передачі на сервері, який використовує наявний RangeRequest але повертає фрагменти замість одного буферованого блоку: сервер внутрішньо розбиває дані на сторінки з адаптивним розміром фрагментів (цільовий розмір кожного фрагмента коригується на основі MaxRequestBytes та розмірів значень, зафіксованих на даний момент), фіксує одну ревізію MVCC, щоб об’єднаний потік залишався узгодженим зі знімком, та обчислює загальну кількість ключів на основі поточного підрахунку, який формується під час потокової передачі, а не шляхом окремого обходу індексу. Ініціалізація кешу спостереження kube-apiserver є основним споживачем, і тепер вона декодує кожен фрагмент у синтетичні події created безпосередньо під час їх надходження, замість того, щоб спочатку збирати повний список у пам’яті; така сама обробка застосовується до прямих викликів GetList, коли WatchList вимкнено.
Ця функція вимагає etcd версії 3.7 або вище; у разі використання старішої версії etcd, kube-apiserver виявляє відповідь Unimplemented і автоматично переходить на унарний Range, без жодних змін у поведінці. Якщо закріплена ревізія ущільнюється в процесі роботи, kube-apiserver трактує це так само, як і будь-яку іншу помилку ініціалізації кешу спостереження, і робить повторну спробу, що не гірше, ніж гонитви за ущільнення, з якими вже сьогодні може зіткнутися виклик List з розбиттям на сторінки. Критерії виходу з бета-версії включають тест на масштабованість, що вимірює затримку при роботі з великими списками на кластері з 5000 вузлів, а команда etcdctl get --stream поставляється разом із нею для тих, хто хоче безпосередньо протестувати новий RPC.
Ця робота була виконана як частина KEP #5966 під керівництвом SIG etcd.
Конкурентне декодування обʼєктів watch
kube-apiserver декодує та перетворює кожну подію спостереження з etcd по черзі в одній goroutine, тому одне повільне перетворення на подію, зокрема виклик вебхука для конвертації CRD, блокує всі події, що стоять у черзі за ним. Це здебільшого створює незручності для вбудованих ресурсів, але для CRD, версія якого в сервісі відрізняється від збереженої, послідовне перетворення «холодного» кешу може займати кілька хвилин. Якщо це перевищує стандартний 5-хвилинний інтервал ущільнення etcd, ревізія, з якої кеш почав читати, ущільнюється до завершення ініціалізації, спостереження не може поновитися, а ініціалізація просто перезапускається і ніколи не завершується для достатньо великого ресурсу, при цьому кожен клієнт, який намагається перелічити або спостерігати за ним, отримує помилки.
Функціональна можливість ConcurrentWatchObjectDecode фактично була у Beta, стандартно вимкнена, з v1.31, і Kubernetes v1.37 стандартно увімкнув її. Це увімкнення переміщує крок декодування/трансформації на обмежений пул робітничих goroutines (10 типово, налаштовано з перебору, що показав, що вигоди отримуються навколо 8–12) замість однієї, з колектором, що збирає події назад у їхній оригінальний порядок перед доставкою, тому порядок подій зберігається точно. У бенчмарках на 150k+ podʼах, лише паралельне декодування скорочує ініціалізацію кешу приблизно на 40%, а приблизно на 55% в поєднанні з новою функцією EtcdRangeStream, що також виходить в цьому випуску (див. KEP 5966). Головний компроміс, за яким варто слідкувати — навантаження на conversion webhook. З увімкненою функцією, до 10 конвертацій тепер можуть одночасно виконуватися для webhookʼа під час ініціалізації кешу замість однієї за раз. Загальний обсяг викликів не змінюється, лише кількість, що виконуються одночасно, отже це переважно стосується webhookʼів, які обмежують власну конкурентність нижче 10.
Ця робота була виконана як частина KEP #6178 під керівництвом SIG API Machinery.
Заходи щодо усунення наслідків використання застарілого контролера
Кожен контролер у kube-controller-manager працює з локального кешу, побудованого шляхом спостереження за kube-apiserver, а цей watch-потік є лише зрештою консистентним. Зміна може зʼявитися за мілісекунди, або це може зайняти секунди чи навіть хвилини під навантаженням. Наразі оператори не мають уявлення про це відставання і не можуть відрізнити нормальну затримку від ситуації, коли контролер небезпечно втратив синхронізацію, тому контролер може продовжувати узгоджувати свої дані з уявленням про стан системи, яке вже є застарілим.
Заходи щодо мінімізації ризиків, пов’язаних із застарілими контролерами, перебувають у стадії бета-тестування з версії v1.36 і є стандартними для кожного контролера за функціональною можливісьтю StaleControllerConsistency<Controller>; у Kubernetes v1.37 ці заходи поширено на контролер HorizontalPodAutoscaler та додано варіант із механізмом відключення (circuit-breaking) і додаткові метрики, описані нижче. Основний механізм — це гарантія read your writes: ResourceEventHandlerFuncs у client-go отримує новий callback BookmarkFunc, щоб контролер міг надійно відстежувати версію ресурсу обʼєктів, які йому цікаві, навіть через крайні випадки, які наявні callbackʼи add/update/delete пропускають. Контролер записує версію ресурсу власних записів і, при наступному узгодженні, пропускає та повторно ставить у чергу, доки його інформер-кеш дійсно не наздогнав цей запис. Контролер DaemonSet — хороший приклад цього. Він відстежує версії ресурсів DaemonSet → Pod, щоб не переузгоджувати проти власного застарілого pod-кешу. Другий, circuit-breaking варіант націлений на контролери, чутливі до затримок, на кшталт node-lifecycle, які інакше могли б прочитати застарілий node lease з кешу і помилково вирішити, що він закінчився; замість цього він робить живий GET на руйнівному рішенні і позначає свій кеш як «not ready», доки він не догонить його, замість того щоб діяти на основі застарілого читання. StaleControllerConsistency контролює саму процедуру пом’якшення наслідків (спочатку застосовується до контролерів, які KCM позначив як великомасштабні), MonitorInformerStaleness — це окремий контрольний механізм, призначений лише для спостереження, який кожні 5 секунд безпосередньо опитує apiserver виключно для того, щоб виявити, наскільки насправді відстає кеш інформера, а AtomicFIFO / UnlockWhileProcessingFIFO — це базові механізми черги завдань client-go, від яких залежить робота механізму помʼякшення наслідків. Ніщо з цього не змінює стандартну поведінку узгоджувача; контролер, який було призупинено та знову поставлено в чергу, може здаватися застряглим, хоча насправді він просто чекає на свій кеш, і він коректно відкочується, оскільки жодна його дія не є незворотною.
Ця робота була виконана як частина KEP #5647 під керівництвом SIG API Machinery.
Конфігурація контролю допуску на основі маніфесту
У Kubernetes контроль допуску відповідає за забезпечення дотримання політик щодо ресурсів до того, як вони будуть прийняті сервером API. Однак вебхуки та політики допуску, налаштовані через API Kubernetes, під час запуску кластера залежать від сервера API та etcd і не можуть захистити самі ресурси конфігурації допуску. Це створює вразливість під час початкового запуску кластера та дозволяє користувачам із достатніми привілеями змінювати або видаляти критично важливі політики допуску.
У Kubernetes v1.37 конфігурація контролю доступу на основі маніфестів перейшла у стадію бета-тестування, що дозволяє завантажувати вебхуки доступу та політики на основі CEL із файлів маніфестів на диску та застосовувати їх із моменту запуску сервера API. Оскільки ця конфігурація управляється незалежно від API Kubernetes, вона також може захищати ресурси контролю доступу на основі API від модифікацій. Файли маніфестів відстежуються на наявність змін, і дійсні оновлення перезавантажуються автоматично, тоді як недійсні оновлення залишають попередньо завантажену конфігурацію без змін.
Ця робота була виконана як частина KEP #5793 під керівництвом SIG API Machinery
Покращена обробка нерозшифровуваних ресурсів
Kubernetes зберігає ресурси в etcd, де шифрування в стані спокою може бути використане для захисту чутливих даних. Однак, коли зашифровані ресурси більше не можуть бути розшифровані, наприклад, тому що ключ шифрування недоступний, API-сервер не може читати або керувати цими ресурсами нормально. Це може залишити ресурси в кластері, до яких неможливо отримати доступ через Kubernetes API, вимагаючи від адміністраторів вручну модифікувати базові дані etcd для відновлення.
Kubernetes v1.37 включає Beta підтримку для адміністраторів кластерів для ідентифікації та видалення ресурсів, які не можуть бути розшифровані API-сервером.
Раніше Alpha, і введена в Kubernetes v1.32, ця підтримка дозволяє видаляти проблемні API-ресурси через Kubernetes API замість безпосереднього маніпулювання файлом etcd. Ця функція також надає засоби безпеки для адміністраторів для перевірки задіяних ресурсів перед видаленням.
Ця робота була виконана як частина KEP #3926 під керівництвом SIG Auth.
Нові функції в Alpha
Нова стратегія Recreate для розгортання StatefulSet
Kubernetes v1.37 вводить стратегію Recreate для розгортання StatefulSet. StatefulSet API раніше пропонував лише дві стратегії оновлення: OnDelete (ручна) та RollingUpdate (автоматична, типово). Схоже на Deployments, стратегія оновлення Recreate видаляє всі Podʼи StatefulSet перед створенням нових Podʼів, що відображають модифікації, зроблені до .spec.template StatefulSet. Використання цієї стратегії вимагає увімкнення функціональної можливості StatefulSetRecreateStrategy.
Ця робота була виконана як частина KEP #3541 під керівництвом SIG Apps.
DRA: Alpha функції, на які варто звернути увагу
DRA: Запит на ресурси, що розподіляються вузлом
Kubernetes v1.37 покращує Alpha підтримку керування ресурсами вузла, такими як CPU, памʼять та huge pages, через DRA. Це обʼєднує стандартний та DRA облік ресурсів, допомагаючи запобігти подвійному рахуванню однієї й тієї ж можливості вузла.
Це оновлення вводить окремі API-поля для mapping (для пристроїв, що безпосередньо моделюють основні ресурси, на кшталт CPU/памʼяті DRA драйверів) та overhead (як допоміжна хост-памʼять для пристроїв прискорення). Kubelet тепер примушує ці виділення між pod та container cgroups, інтегрує їх з Memory QoS, розрахунками OOM score та in-place зміною розміру podʼа.
Ця робота була виконана як частина KEP #5517, під керівництвом SIG Scheduling з участю SIG Node.
DRA: Похідні атрибути
Kubernetes v1.37 вводить Alpha підтримку похідних атрибутів у DRA. Навантаження можуть використовувати CEL-вирази для створення віртуальних атрибутів з інформації про пристрої та використання їх при виборі повʼязаних пристроїв.
Це полегшує ко-локацію пристроїв, таких як GPU та мережеві інтерфейси, навіть коли їх драйвери використовують різні імена атрибутів або формати. Наприклад, навантаження може вивести спільний NUMA ідентифікатор і використати його для вибору пристроїв з відповідною топологією.
Ця робота була виконана як частина KEP #6080, під керівництвом SIG Scheduling з участю SIG Network.
DRA: Групи сумісності пристроїв
DRA можна використовувати для управління пристроями, що підтримують різні схеми розділення або віртуалізації. Однак деякі з цих конфігурацій не можна використовувати одночасно на одному фізичному пристрої, наприклад MIG і vGPU на графічному процесорі. Раніше ці несумісності можна було виявити лише під час підготовки пристрою, після того як планувальник уже прийняв своє рішення.
У Kubernetes v1.37 DRA додає групи сумісності пристроїв, дозволяючи драйверам ресурсів описувати, які пристрої можуть бути виділені разом. Планувальник може використовувати цю інформацію при прийнятті рішень про виділення, запобігаючи призначенню некомплектних пристроїв разом і уникаючи помилок запуску Podʼів, спричинених некомплектними конфігураціями пристроїв.
Ця робота була виконана як частина KEP #5963, під керівництвом SIG Scheduling.
Витіснення планувальником для in-place зміни розміру Podʼа
Kubernetes v1.37 вводить витіснення планувальником для in-place зміни розміру podʼа, за (opt-in, Alpha) функціональною можливістю InPlacePodVerticalScalingSchedulerPreemption. Ця зміна вирішує важливу прогалину функціоналу, що залишилася після того, як основна функція вертикального масштабування Podʼа на місці перейшла в Stable: якщо запущений pod запитував додаткові ресурси, що перевищували доступну ємність вузла, kubelet позначав запит як Deferred, залишаючи pod очікувати, поки достатньо ресурсів не стане доступними на вузлі. Завдяки цьому вдосконаленню панель управління Kubernetes може активно звільняти ємність на повністю завантаженому вузлі та витісняти навантаження з нижчим пріоритетом, дозволяючи відкладеним in-place запитам на зміну розміру критичних застосунків з вищим пріоритетом успішно завершитися.
Ця робота була виконана як частина KEP #5836 під керівництвом SIG Scheduling.
Динамічна зміна розміру memory-backed томів
Також спираючись на вертикальне масштабування Podʼів «на місці», функція Alpha масштабування на місці для томів, що підтримуються памʼяттю розширює субресурс pod /resize, який раніше дозволяв лише динамічне регулювання CPU та памʼяті без перезапуску контейнерів, щоб підтримати оновлення параметра sizeLimit томів emptyDir, що підтримуються памʼяттю (medium: Memory), у запущених Podʼах. Коли параметр sizeLimit тома явно регулюється за допомогою субресурсу /resize, Kubelet динамічно оновлює базове монтування tmpfs без переривання роботи контейнера, одночасно надійно запобігаючи помилкам нестачі памʼяті або помилковим спрацьовуванням механізмів витіснення. Це особливо корисно для робочих навантажень із збереженням стану та з інтенсивним використанням памʼяті, які покладаються на тимчасове зберігання даних у памʼяті, що дозволяє їм динамічно масштабувати межі зберігання разом із об’ємом пам’яті контейнера без перезапуску подів або простоїв застосунків.
Це альфа-функція, яка вмикається за бажанням користувача і зазвичай вимкнена. Щоб спробувати її, увімкніть функціональну можливість InPlacePodVerticalScalingMemoryBackedVolumes.
Ця робота була виконана як частина KEP #6030 під керівництвом SIG Node та SIG Storage.
Спеціалізоване управління життєвим циклом вузлів
Декілька компонентів Kubernetes потребують інформації про стан життєвого циклу вузла, і на сьогодні кожен із них визначає його на основі різного поєднання готовності вузла, позначок taint, стану Pod, міток, анотацій та API-інтерфейсів провайдерів. Це вдосконалення запроваджує загальновизнані умови життєвого циклу для вузлів, надаючи адміністраторам єдине місце в Kubernetes для публікації стану життєвого циклу, яке можуть використовувати основні контролери та інструменти екосистеми. Ці нові умови вузлів (Node Conditions) такі: DrainInProgress, Drained, MaintenancePlanned, MaintenanceInProgress та GracefulNodeShutdownInProgress
Ця робота була виконана як частина KEP #5683 під керівництвом SIG Node.
WAS: Alpha функції, на які варто звернути увагу
CompositePodGroup API
Попередні випуски вводили підтримку групового планування навантажень з плоскою структурою, сучасні AI/ML навантаження є складними і мають більш витончені вимоги до планування. У Kubernetes v1.37 новий Alpha CompositePodGroup API дозволяє Kubernetes описувати складні навантаження як ієрархію груп замість плаского набору Podʼів. Це дозволяє багаторівневе групове планування, workload-aware preemption та topology-aware планування.
Ця робота була виконана як частина KEP #6012 під керівництвом SIG Scheduling.
API контролера планування з урахуванням навантаження
Як Alpha функція, в Kubernetes v1.37 надається спільний фреймворк для інтеграції контролерів навантажень (таких як JobSet, TrainJob, LWS, та RayJob, поряд з основними навантаженнями, такими як Job) з Workload-aware Scheduling (WAS). Які функція альфа-версії, Kubernetes v1.37 надає загальну платформу для інтеграції контролерів робочих навантажень (таких як JobSet, TrainJob, LWS та RayJob, а також основних робочих навантажень, таких як Job) із плануванням з урахуванням робочих навантажень (WAS).
Ця робота була виконана як частина KEP #6089 під керівництвом SIG Scheduling.
Інтеграція Workload API з Job контролером
Спочатку введена в Kubernetes v1.36 з обмеженим функціоналом, ця функція будує на Workload Aware Scheduling Controller APIs, додаючи нове поле spec.scheduling для користувача до batch/v1 Job у Kubernetes v1.37, дозволяючи користувачам явно конфігурувати політики планування, обмеження топології, режими розладів (disruption modes) та resource claims. Якщо spec.scheduling виключено, Job типово використовує Basic планування, зберігаючи наявну поведінку, при цьому створюючи Basic Workload/PodGroup для workload-aware планування, без використання minCount gate. Користувачі можуть явно використовувати (opt in) Gang планування, де minCount типово дорівнює паралелізму Jobʼа, а контролер використовує спільну бібліотеку workloadbuilder для перекладу конфігурації планування у відповідні обʼєкти Workload та PodGroup замість реалізації власної логіки перекладу.
Ця робота була виконана як частина KEP #5547 під керівництвом SIG Scheduling.
Проксі користувацького простору (userspace) для localhost NodePort для nftables
Kubernetes v1.37 додає opt-in userspace проксі до nftables бекенду kube-proxy, дозволяючи NodePort сервісам бути доступними через localhost поверх IPv4 та IPv6. Це закриває прогалину між nftables та iptables бекендами, оскільки nftables раніше не міг обслуговувати localhost NodePortʼи.
Проксі увімкнено, коли localhost або loopback-адреса включена в конфігурацію --nodeport-addresses kube-proxy. Це може бути корисним для навантажень, таких як локальні контейнерні реєстрі, що покладаються на зʼєднання localhost:<NodePort>. Наявна поведінка iptables та ipvs бекендів незмінна.
Ця робота була виконана як частина KEP #6032 під керівництвом SIG Network.
Інші значущі зміни
maxUnavailable для StatefulSets знову стандартно увімкнено
Поле maxUnavailable для StatefulSets було знову стандартно увімкнено у Kubernetes v1.37 (після того, як баг був виявлений у v1.36).
Баг виникав, коли несправна початкова ревізія StatefulSet створювала Pod, який ніколи не ставав ready, і з увімкненим MaxUnavailableStatefulSet, контролер StatefulSet не міг оновити той Pod до новій, виправленій ревізії. Коли баг спрацьовував, зазначений Pod міг застрягти в стані CrashLoopBackOff безкінечно (див. kubernetes#137409).
Покращена продуктивність nftables
kube-proxy тепер використовує kernel netlink інтерфейс для операцій з правилами nftables, обходячи утиліту командного рядка nft. Це робить kube-proxy ефективнішим при перевірці та управлінні правилами nftables, покращуючи продуктивність управління правилами.
Обробка контексту та контекстне логування в client-go
Підтримка розповсюдження контексту та контекстного логування в client-go завершена, за винятком невеликої кількості викликів логування втулків автентифікації, які все ще покладаються на глобальний klog логер, бо базові API не підтримують передачу контексту.
Зміна статусу, застарілі та видалені функції у v1.37
Переходи в Stable
Цей розділ перераховує всі функції, що перейшли в Stable (також відомі як загальна доступність). Для повного списку оновлень, включаючи нові функції та переходи з Alpha в Beta, дивіться примітки до випуску.
Цей випуск включає загалом 16 вдосконалень, переведених у Stable:
- Прискорення рекурсивної зміни міток SELinux
- ClusterTrustBundles
- Сертифікати Podʼів
- Дозволити встановлення довільного FQDN як hostname podʼа
- DRA: Статус Resource Claim з можливими стандартизованими даними мережевого інтерфейсу
- Налаштована толерантність для HorizontalPodAutoscalers
- Спрощена валідація для імен Services
- Додавання Resource Health Status до Pod Status для Device Plugin та DRA
- DRA: taint та toleration пристроїв
- DRA: Обробка запитів розширених ресурсів через DRA Driver
- Функції, оголошені вузлом
- Додавання станів для створення sandboxʼу
- Переміщення Storage Version Migrator in-tree
- Стійка ініціалізація Watchcache
- DRA: Стандартний атрибут пристрою numaNode
- Визначення API metrics.k8s.io
- KYAML
Застарілі функції, видалення та оновлення від спільноти
У міру розвитку та вдосконалення Kubernetes окремі функції можуть бути визнані застарілими, видалені або замінені кращими з метою забезпечення загального стабільного функціонування проєкту. Деталі цього процесу дивіться в політиці застарівання та видалення Kubernetes. Багато з цих застарівань та видалень були оголошені в блозі про застарівання та видалення.
Застарівання kube-dns
CoreDNS є стандартною надбудовою для кластерного DNS, починаючи з версії Kubernetes v1.113, і з того часу kube-dns не встигає за ним; такі функції, як EndpointSlices та сервіси з подвійним стеком, у ньому недоступні.
Kubernetes вже вивів kube-dns субпроєкт і виділив node-local-dns в окремий репозиторій, де він продовжує підтримуватися і працює з CoreDNS. Очікується, що нові пакети для kube-dns не будуть збиратися після v1.40.
Якщо ви все ще використовуєте kube-dns, почніть планувати міграцію ваших кластерів на CoreDNS.
Припинення підтримки режиму ipvs у kube-proxy
Підтримка режиму ipvs в kube-proxy була введена в v1.8 для вирішення вузьких місць продуктивності iptables. Однак, оскільки kernel ipvs API самостійно не може повністю реалізувати Kubernetes Services, режим ipvs продовжує використовувати iptables під капотом (KEP-3866, "The ipvs mode of kube-proxy will not save us").
Кластери, що запускають kube-proxy в режимі ipvs (або mode: ipvs в KubeProxyConfiguration), тепер логують попередження про застарівання при запуску. Графік застарівання виглядає так:
- До v1.40, режим
ipvsдляkube-proxyочікується стандартно вимкненим (його все ще можна вибірково включати через функціональну можливість) - До v1.43, підтримка режиму
ipvsбуде видалена повністю KEP #5495, Graduation Criteria.
Для підтвердження того, який режим ви зараз використовуєте, виконайте:
kubectl -n kube-system get configmap kube-proxy -o jsonpath=ʼ{.data.config\.conf}ʼ | grep ʼmode:ʼ
Щоб зрозуміти обґрунтування цього застарівання, дивіться KEP #5495.
kubectl: прапорець kubectl run --filename/-f застаріває
Прапорець --filename (або -f) для kubectl run оголошується застарілим, оскільки генерований pod завжди будується виключно з CLI аргументів на кшталт NAME та --image.
Дивіться kubernetes/kubernetes#138671 для оригінального issue та обговорення.
kubelet: статичні Podʼи більше не можуть посилатися на Secrets або ConfigMaps
Статичні Podʼи ніколи не призначалися для читання API-ресурсів безпосередньо, оскільки вони не створюються через API-сервер — але баг дозволяв їм посилатися на Secrets або ConfigMaps через поля на кшталт configMapRef або secretRef. Цей баг тепер виправлений: починаючи з v1.37 ці посилання суворо заборонені, а функціональна можливість PreventStaticPodAPIReferences, що раніше дозволяв відмовитися від обмеження, був видалений.
Дивіться kubernetes/kubernetes#140226 для оригінального issue та обговорення.
Поточна велика зміна: майбутнє видалення підтримки cgroup v1
Оскільки сучасні Linux дистрибутиви та рушії виконання контейнерів стандартно використовують cgroup v2, підтримка застарілих cgroup v1 офіційно виводиться з експлуатації. З випуску v1.35 налаштування failCgroupV1 типово дорівнює true. Отже, kubelet не зможе ініціалізуватися на будь-яких вузлах, що все ще покладаються на cgroup v1, якщо не застосовано явний перевизначення конфігурації.
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
failCgroupV1: false # тимчасове перевизначення
Використання цього перевизначення слід розглядати як короткострокове виправлення. Розширені можливості керування ресурсами, такі як memory QoS та in-place масштабування для memory-backed томів, працюють лише на cgroups v2. Хоча перевизначення залишається доступним у Kubernetes v1.37, користувачів заохочують мігрувати на cgroups v2, оскільки підтримка cgroups v1 планується бути видаленою у майбутньому випуску.
Щоб дізнатися більше про це застарівання, зверніться до KEP #5573.
Примітки до випуску
Перегляньте повні деталі релізу Kubernetes v1.37 в наших примітках до випуску.
Доступність
Kubernetes v1.37 доступний для завантаження з сторінки завантаження Kubernetes або безпосередньо з GitHub.
Щоб розпочати роботу з Kubernetes, перегляньте ці настанови або запустіть локальні Kubernetes кластери за допомогою minikube. Ви також можете легко встановити v1.37 за допомогою kubeadm.
Команда випуску
Kubernetes можливий лише завдяки підтримці, відданості та важкій роботі своєї спільноти. Кожна команда випуску складається з відданих волонтерів спільноти, які працюють разом, щоб створити багато частин, що складають Kubernetes релізи, на які ви покладаєтеся.
Це вимагає спеціалізованих навичок людей з усіх куточків нашої спільноти, від самого коду до його документації та управління проєктом.
Ми хотіли б подякувати всій команді, що працювала над випуском за години наполегливої праці, завдяки яким випуск Kubernetes v1.37 став доступним для нашої спільноти.
До складу команди з випуску входять як новачки, які вперше беруть участь у проєкті, так і досвідчені керівники команд, які вже брали участь у кількох циклах випуску.
Особлива подяка нашому керівнику випуску, Діпешу Равату, за підтримку протягом успішного циклу випуску, за те, що він відстоював наші інтереси, дбав про те, щоб ми всі могли зробити свій внесок якнайкраще, та спонукав нас вдосконалювати процес випуску.
Швидкість проєкту
Проєкт CNCF K8s DevStats агрегує ряд цікавих даних, повʼязаних із швидкістю Kubernetes та різних субпроєктів.
Це включає все від індивідуальних внесків до кількості компаній, що роблять внесок, і є ілюстрацією глибини та широти зусиль, що йдуть на еволюцію цієї екосистеми.
У циклі релізу v1.37, що тривав 15 тижнів з 18 травня 2026 року по 26 серпня 2026 року, внески в Kubernetes досягли максимуму у 212 різних компаній та 1,754 окремих осіб.
Джерело цих даних:
Під внеском ми маємо на увазі, коли хтось виконує коміт, проводить рецензію коду, залишає коментар, створює тікет або PR, рецензує PR (включно з блогами та документацією) або коментує тікети та PR.
Якщо ви бажаєте долучитися до проєкту, перегляньте нашу сторінку «Як розпочати».
Події
Дізнайтесь про майбутні KubeCon по всьому світу:
- KubeCon + CloudNativeCon China: 7–9 вересня 2026, Шанхай, Китай
- KubeCon + CloudNativeCon North America: 9–12 листопада 2026, Солт-Лейк-Сіті, США
Дізнайтесь про майбутні Kubernetes Community Days (KCDs), які відбуватимуться до кінця 2026 року:
Вересень 2026
- KCD x Ceph x OpenInfra Day Korea: 1 вересня 2026, Сеул, Південна Корея
- KCD San Francisco Bay Area: 1 вересня 2026, Маунтн-Вʼю, США
- KCD Washington DC: 15 вересня 2026, Вашингтон, округ Колумбія, США
- KCD Gujarat: 19 вересня 2026, Ахмедабад, Індія
- KCD São Paulo: 26 вересня 2026, Сан-Паулу, Бразилія
- KCD Sofia: 29 вересня 2026, Софія, Болгарія
Жовтень 2026
- KCD UK – Edinburgh: 19–20 жовтня 2026, Единбург, Велика Британія
- KCD Nigeria: 24 жовтня 2026, Лагос, Нігерія
Листопад 2026
- KCD Porto: 19–20 листопада 2026, Порто, Португалія
- KCD Hangzhou: 28 листопада 2026, Ханчжоу, Китай
Грудень 2026
- KCD Suisse Romande: 9–10 грудня 2026, Мейрін, Швейцарія
- KCD Provence: 10 грудня 2026, Екс-ан-Прованс, Франція
- KCD Florida – Miami: 11 грудня 2026, Маями, США
Актуальну інформацію про заходи можна знайти на сторінці заходів CNCF.
Вебінар присвячений релізу
Приєднуйтесь до членів команди випуску Kubernetes v1.37 у середу, 23 вересня 2026 о 16:00 (UTC), щоб дізнатися про головні моменти цього релізу. Для отримання інформації та реєстрації відвідайте сторінку події на сайті CNCF Online Programs.
Приєднуйтесь
Найпростіший спосіб залучитися до Kubernetes — приєднатися до однієї з багатьох Special Interest Groups (SIGs), що відповідають вашим інтересам.
Якщо ви не знаєте, з чого почати, приєднуйтесь до наших щомісячних навчальних семінарів для нових учасників New Contributor Orientations, де ми розповідаємо учасникам спільноти про структуру проєкту та допоможемо вам зробити свій перший внесок у проєкт.
- Прочитайте більше про те, як стати Kubernetes Contributor
- Прочитайте більше про те, що відбувається з Kubernetes у нашому блозі
- Приєднуйтесь до нас у Slack
- Слідкуйте за нами в Bluesky для останніх оновлень
- Слідкуйте за нами в LinkedIn
- Слідкуйте за нами в X
- Приєднуйтесь до обговорення спільноти в Discuss
- Задавайте питання (або відповідайте на них) на Stack Overflow
- Поділіться вашою Kubernetes End User Story
- Дізнайтеся більше про Kubernetes Release Team
Створення власного експортера метрик для Kubernetes
Kubernetes має вбудовану підтримку моніторингу CPU та памʼяті, але більшість рішень щодо масштабування в реальних сценаріях залежать від сигналів, які знаходяться повністю поза цими вузькими межами: скільки повідомлень чекають у черзі, скільки часу тривало останнє пакетне завдання, скільки активних WebSocket-зʼєднань утримує Pod. Коли вбудованих метрик недостатньо, експортер метрик заповнює цю прогалину.
У цій статті ми розглянемо створення такого експортера з нуля, пакування його в контейнер та підключення до кластера, щоб Prometheus, і зрештою HorizontalPodAutoscaler, могли його використовувати.
Що насправді робить експортер метрик
Експортер — це невеликий HTTP-сервер з єдиним завданням: повідомляти стан застосунку у вигляді тексту в точці доступу /metrics. Prometheus збирає дані з цієї точки доступу з певним інтервалом, зберігає часові ряди та робить їх доступними для запитів, сповіщень і правил автомасштабування.
У деяких випадках ви можете інструментувати застосунок безпосередньо — вбудувати клієнтську бібліотеку Prometheus та відкрити /metrics всередині того ж процесу, замість запуску окремого експортера. Окремий експортер має більше сенсу, коли джерело даних знаходиться зовні вашого застосунку або коли ви не контролюєте код застосунку.
Формат, який очікує Prometheus — це звичайний текст: одна метрика на рядок, з назвою, опціональними мітками та числовим значенням. Клієнтські бібліотеки беруть на себе серіалізацію, тому на практиці вам потрібно лише вирішити, що вимірювати, та викликати відповідну функцію, коли значення змінюється.
Вибір того, що вимірювати
Перед написанням коду варто визначитися, з яким типом сигналу ви маєте справу. Модель даних Prometheus має три основні типи:
-
Лічильники (Counters) лише збільшуються. Вони підходять для підсумкових значень: кількість оброблених запитів, виконаних завдань, виниклих помилок. Ніколи не використовуйте лічильник для значення, яке може зменшуватися.
-
Вимірювачі (Gauges) представляють поточний знімок значення, яке може вільно зростати та спадати. Глибина черги, активні зʼєднання та розмір кешу — все це вимірювачі.
-
Гістограми (Histograms) записують розподіл спостережуваних значень, наприклад, затримку запитів. Вони дозволяють обчислювати перцентилі (p99, p50), а не лише середні значення.
Коли ви знаєте, який тип підходить для вашого сигналу, оберіть назву відповідно до конвенції <namespace>_<name>_<unit> у форматі snake_case. Обробник завдань може надавати worker_jobs_processed_total (лічильник), worker_queue_depth (вимірювач) та worker_job_duration_seconds (гістограма). Зрозумілі назви заощаджують час усім під час налагодження.
Налаштування проєкту
Клієнт Prometheus для Go є найпоширенішим вибором для експортерів в екосистемі Kubernetes, значною мірою тому, що ця ж бібліотека використовується в більшості офіційних компонентів Kubernetes. Почніть зі створення модуля та додавання залежності:
mkdir my-exporter && cd my-exporter
go mod init example.com/my-exporter
go get github.com/prometheus/client_golang/prometheus
go get github.com/prometheus/client_golang/prometheus/promhttp
Реєстрація метрик
Створіть main.go. Перше, що потрібно зробити — оголосити метрики та зареєструвати їх у типовому реєстрі Prometheus. Реєстрація повідомляє бібліотеці, що ці метрики існують, тому вони зʼявляться у виводі навіть до того, як буде записано перше спостереження:
package main

import (
    "log"
    "net/http"

    "github.com/prometheus/client_golang/prometheus"
    "github.com/prometheus/client_golang/prometheus/promhttp"
)

var (
    jobsProcessed = prometheus.NewCounterVec(
        prometheus.CounterOpts{
            Name: "worker_jobs_processed_total",
            Help: "Total number of jobs processed, partitioned by status.",
        },
        []string{"status"},
    )

    queueDepth = prometheus.NewGauge(prometheus.GaugeOpts{
        Name: "worker_queue_depth",
        Help: "Current number of jobs waiting in the queue.",
    })

    jobDuration = prometheus.NewHistogram(prometheus.HistogramOpts{
        Name:    "worker_job_duration_seconds",
        Help:    "Time spent processing a single job.",
        Buckets: prometheus.DefBuckets,
    })
)

func init() {
    prometheus.MustRegister(jobsProcessed, queueDepth, jobDuration)
}
prometheus.MustRegister викликає паніку у разі дублювання реєстрації, що дозволяє виявити помилки в налаштуваннях одразу під час запуску, а не непомітно під час роботи. Якщо ви вбудовуєте цей експортер у бібліотеку, яку будуть інструментувати інші пакети, використовуйте prometheus.Register та обробляйте помилку самостійно.
Збір реальних значень
Після реєстрації метрик наступний крок — підтримувати їх в актуальному стані. Ви можете або постійно оновлювати дані в міру їх зміни, або запустити власний внутрішній цикл оновлення. У прикладі нижче показано цикл опитування — goroutine, що періодично читає дані з вашого джерела даних та оновлює зареєстровані метрики. Замініть імітовані значення реальними викликами до вашої бази даних, внутрішнього API або брокера повідомлень:
import (
    "math/rand"
    "time"
)

func collectMetrics() {
    for {
        // Замініть це на реальні дані з вашого застосунку.
        depth := float64(rand.Intn(50))
        queueDepth.Set(depth)

        start := time.Now()
        time.Sleep(time.Duration(rand.Intn(200)) * time.Millisecond)
        jobDuration.Observe(time.Since(start).Seconds())
        jobsProcessed.WithLabelValues("success").Inc()

        time.Sleep(5 * time.Second)
    }
}
Інтервал опитування (тут пʼять секунд) має бути коротшим за інтервал збору Prometheus, щоб кожен збір бачив свіже значення. Типовий інтервал збору в більшості розгортань кластера становить пʼятнадцять секунд, що дає комфортний запас.
Експонування точки доступу
Обʼєднайте цикл збору та HTTP-обробник у main. Шлях /healthz разом із /metrics надає Kubernetes ціль для проб життєздатності (liveness probe), не експонуючи дані метрик на цьому шляху:
func main() {
    go collectMetrics()

    http.Handle("/metrics", promhttp.Handler())
    http.HandleFunc("/healthz", func(w http.ResponseWriter, r *http.Request) {
        w.WriteHeader(http.StatusOK)
    })

    log.Println("Listening on :8080")
    if err := http.ListenAndServe(":8080", nil); err != nil {
        log.Fatalf("server error: %v", err)
    }
}
Перевірте вивід локально перед створенням образу:
go run .
curl http://localhost:8080/metrics | grep worker_
Ви маєте побачити три блоки # HELP та # TYPE, за якими слідують поточні значення метрик. Якщо ці рядки зʼявилися, експортер працює правильно та готовий до контейнеризації.
Створення образу контейнера
Багатоетапна збірка зберігає кінцевий образ невеликим та дозволяє не постачати інструменти Go у промислове середовище. Перший етап компілює статично зібраний бінарний файл; другий етап копіює лише цей бінарний файл у мінімальний базовий образ. Приклад нижче використовує Docker, але той самий підхід працює з будь-яким OCI-сумісним інструментом, як-от Buildah або Podman:
FROM golang:1.21-alpine AS builder
WORKDIR /src
COPY go.mod go.sum ./
RUN go mod download
COPY . .
RUN CGO_ENABLED=0 go build -o /exporter .

FROM gcr.io/distroless/static:nonroot
COPY --from=builder /exporter /exporter
EXPOSE 8080
ENTRYPOINT ["/exporter"]
distroless/static:nonroot не містить оболонки, менеджера пакунків і типово працює від імені непривілейованого користувача, що відповідає більшості політик безпеки кластера без додаткового налаштування.
Зберіть та відправте образ, замінивши <registry> на адресу вашого реєстру:
docker build -t <registry>/my-exporter:v1.0.0 .
docker push <registry>/my-exporter:v1.0.0
(Примітка: використання конвеєра CI/CD для автоматизації цього процесу зазвичай є кращим підходом, ніж ручне виконання цих команд.)
Розгортання в кластері
Двох маніфестів достатньо для запуску експортера: Deployment, який керує життєвим циклом Podʼів, та Service, який надає Prometheus стабільну адресу для збору даних. (Ви можете налаштувати Prometheus на збір даних з кожного Podʼа; якщо це має сенс для вашого випадку використання, то це також допустимо).
Приклади нижче використовують простір імен monitoring, що є поширеною практикою при запуску Prometheus та повʼязаних компонентів разом. Відкоригуйте простір імен відповідно до налаштувань вашого кластера.
Deployment встановлює консервативні обмеження ресурсів, прийнятні для легковагового процесу в стилі sidecar, та використовує шлях /healthz для своєї проби життєздатності (liveness probe):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-exporter
  namespace: monitoring
  labels:
    app.kubernetes.io/name: my-exporter
spec:
  replicas: 1
  selector:
    matchLabels:
      app.kubernetes.io/name: my-exporter
  template:
    metadata:
      labels:
        app.kubernetes.io/name: my-exporter
    spec:
      containers:
      - name: exporter
        image: <registry>/my-exporter:v1.0.0
        ports:
        - name: metrics
          containerPort: 8080
        livenessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        resources:
          requests:
            cpu: 50m
            memory: 32Mi
          limits:
            cpu: 100m
            memory: 64Mi
Service називає порт metrics, на який посилатиметься ServiceMonitor у наступному розділі:
apiVersion: v1
kind: Service
metadata:
  name: my-exporter
  namespace: monitoring
  labels:
    app.kubernetes.io/name: my-exporter
spec:
  selector:
    app.kubernetes.io/name: my-exporter
  ports:
  - name: metrics
    port: 8080
    targetPort: metrics
Застосуйте обидва:
kubectl apply -f deployment.yaml -f service.yaml
Налаштування Prometheus для пошуку експортера
Спосіб налаштування збору даних залежить від того, як встановлено Prometheus.
Варіант 1: Prometheus Operator (ServiceMonitor)
Якщо ви встановили Prometheus за допомогою Prometheus Operator або Helm-чарту kube-prometheus-stack, оператор має бути запущений у вашому кластері перед створенням ServiceMonitor. Мітка release має збігатися з селектором міток, налаштованим у вашому ресурсі Prometheus — kube-prometheus-stack є типовим значенням для стандартного встановлення Helm:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: my-exporter
  namespace: monitoring
  labels:
    release: kube-prometheus-stack
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: my-exporter
  endpoints:
  - port: metrics
    interval: 15s
    path: /metrics
Варіант 2: Виявлення на основі анотацій
Якщо ваш Prometheus використовує виявлення Podʼів на основі анотацій, вам знадобиться відповідне правило scrape_config у конфігурації Prometheus — перевірте з тим, хто керує вашим примірником Prometheus, щоб підтвердити наявність такого правила.
Ви можете додати наступні три анотації до шаблону Podʼа незалежно від методу збору. Вони ігноруються Prometheus Operator, але автоматично підхоплюються системами на основі анотацій:
annotations:
  prometheus.io/scrape: "true"
  prometheus.io/port: "8080"     # опустіть, якщо не використовуєте виявлення на основі анотацій
  prometheus.io/path: "/metrics" # опустіть, якщо не використовуєте виявлення на основі анотацій
Якщо ви не впевнені, яке налаштування використовує ваш кластер, підхід із ServiceMonitor є більш явним і простішим у налагодженні.
Перевірка збору даних
Виконайте перенаправлення порту до сервісу Prometheus та відкрийте сторінку targets, щоб підтвердити, що експортер знайдено:
kubectl port-forward svc/prometheus-operated 9090 -n monitoring
Перейдіть на http://localhost:9090/targets. Ціль my-exporter має відображатися зі статусом UP. Якщо відображається DOWN, перевірте, чи збігається мітка release у ServiceMonitor та чи працює Pod:
kubectl get pods -n monitoring -l app.kubernetes.io/name=my-exporter
kubectl describe servicemonitor my-exporter -n monitoring
Коли ціль стане працездатною, виконайте швидкий запит у браузері виразів (expression browser), щоб підтвердити надходження даних:
rate(worker_jobs_processed_total{status="success"}[2m])
Ненульовий результат означає, що весь конвеєр працює: ваш застосунок генерує дані, Prometheus їх збирає, а часові ряди зберігаються та доступні для запитів.
Що далі
Робочий експортер — це фундамент, а не кінцева мета. Наступним логічним кроком є передача цих метрик до HorizontalPodAutoscaler, щоб ваше навантаження масштабувалося на основі сигналів, які дійсно визначають навантаження, а не лише CPU. Для цього потрібен адаптер метрик (найпоширеніший варіант — Prometheus Adapter), який реєструє ваші власні метрики в Kubernetes Custom Metrics API. Після реєстрації будь-який HorizontalPodAutoscaler у кластері може посилатися на worker_queue_depth або worker_jobs_processed_total безпосередньо у своєму блоці metrics.
Інструкцію з налаштування дивіться в Автомасштабування на основі кількох метрик і власних метрик. Каталог готових експортерів для баз даних, брокерів повідомлень і хмарних сервісів доступний на сторінці Prometheus exporters and integrations.
Керування AI/ML навантаженнями в Kubernetes: втулок Headlamp для Kubeflow
Kubernetes непомітно став стандартною платформою для AI та машинного навчання. Незалежно від того, чи ви запускаєте сервери notebook для дослідників даних, плануєте розподілені тренувальні завдання, налаштовуєте гіперпараметри чи керуєте багатоступеневими ML-пайплайнами, ці навантаження дедалі частіше потрапляють в кластер Kubernetes. Kubeflow — одна з найпопулярніших платформ для складання такого стеку, і вона робить це природним для Kubernetes способом: кожна можливість надається як Custom Resource Definition (CRD).
Такий дизайн є подарунком для операторів кластерів, оскільки це означає, що за ML-навантаженнями можна спостерігати та керувати ними тими ж примітивами, що й усіма іншими в кластері. Але на практиці спеціалізовані ML-інфопанелі, що постачаються з цими платформами, приховують Kubernetes-рівень під собою. Коли notebook застрягає або тренувальний запуск завершується невдало, оператор часто змушений повернутися до kubectl, щоб дізнатися, що насправді сталося на рівні Podʼа.
Тут представлено втулок Headlamp для Kubeflow, який усуває цю прогалину, показуючи власні ресурси Kubeflow безпосередньо в універсальному інтерфейсі Kubernetes. Це наочний приклад підходу, якого може дотримуватися будь-яка платформа, що активно використовує CRD: взаємодіяти з операторами там, де вони вже працюють, і надавати їм достовірну інформацію на рівні кластера.
Сам Headlamp — це розширюваний веб-інтерфейс Kubernetes, що підтримується Kubernetes SIG UI та ліцензований за ліцензією Apache 2.0. Він працює як десктоп-застосунок або в кластері, а його система втулків дозволяє будь-кому додавати першокласні представлення для власних ресурсів.
Чому операторам потрібне інше представлення
Спеціалізовані ML-інфопанелі допомагають дослідникам даних подавати експерименти, пайплайни та notebookʼи. Оператори кластерів та інженери надійності сайтів (SRE) шукають несправності в Kubernetes-ресурсах, що лежать в їх основі, і вони задають інші запитання:
- Чому notebook застряг? Чи це
ImagePullBackOff,OOMKilledчи Pod, що очікує PersistentVolumeClaim? - Які ресурси Run нещодавно завершилися невдало в різних просторах імен?
- Який набір параметрів Katib Experiment визнає оптимальним?
- Чи посилаються ресурси TrainJob на очікувані ресурси TrainingRuntime?
- Які пакетні навантаження виконуються та який стан показує Kubernetes?
Втулок Headlamp Kubeflow допомагає відповісти на ці запитання, зчитуючи дані безпосередньо з API-сервера Kubernetes. Він показує умови Podʼів, причини збоїв в Kubernetes та ресурси в різних просторах імен без необхідності посередницького ML-сервісу чи бази даних.
Що охоплює цей втулок
Kubeflow є модульним, і команди часто встановлюють лише ті компоненти, які їм потрібні. Втулок виявляє API-групи Kubeflow у кластері та показує лише відповідні розділи.
Втулок підтримує такі родини компонентів та API-ресурси:
| Компонент | Призначення | API-ресурси |
|---|---|---|
| Notebooks | Надає середовища розробки, такі як Jupyter, VS Code та RStudio | Notebook, Profile, PodDefault |
| Pipelines | Визначає та відстежує пайплайни, версії, експерименти, запуски та розклади | Pipeline, PipelineVersion, Run, RecurringRun, Experiment |
| Katib | Автоматизує налаштування гіперпараметрів та пошук нейронних архітектур | Experiment, Trial, Suggestion |
| Training | Виконує розподілені тренувальні навантаження, такі як завдання PyTorch та TensorFlow | TrainJob, TrainingRuntime, ClusterTrainingRuntime |
| Spark | Виконує масштабну обробку даних за допомогою Apache Spark | SparkApplication, ScheduledSparkApplication |
Що ви можете побачити
Інспектуйте Podʼи notebook
Детальний вигляд Notebook показує умови Podʼів та їхні поля reason та message. Він також показує запити та обмеження CPU, памʼяті та GPU; монтування томів та їхні типи, такі як PersistentVolumeClaim, ConfigMap, Secret чи emptyDir; змінні середовища, що посилаються на Secret чи ConfigMap обʼєкти; sidecar-контейнери; та toleration вузлів. Цей вигляд консолідує інформацію, яка в іншому випадку вимагала б кількох команд kubectl describe.
Інспектуйте налаштування гіперпараметрів
Представлення Katib показують алгоритм налаштування, простір пошуку, кожен Trial з його поточним статусом та поточний найкращий Trial з його метричними значеннями та призначеннями параметрів. Вони також показують конфігурацію раннього зупинення та кількість ресурсів Trial, що зупинилися рано, щоб ви могли слідкувати за пошуком, не виходячи з UI кластера.
Інспектуйте стан пайплайну без бази даних бекенду
Представлення Pipelines зчитують Kubernetes-ресурси API безпосередньо та не запитують Kubeflow Pipelines API-сервіс чи базу даних бекенду. Ви можете інспектувати збережений стан пайплайну навіть коли цей сервіс недоступний. Детальний вигляд Pipeline надає порівняння останньої та попередньої версій PipelineVersion у вигляді паралельного порівняння у форматі YAML. Представлення Run показують стан та тривалість, представлення RecurringRun показують зрозумілі розклади, а представлення artifacts агрегує значення pipelineRoot з останніх ресурсів Run.
Мапа ML-ресурсів
Втулок реєструє Headlamp map source, що показує ресурси Notebook, Profile, PodDefault, Experiment, Pipeline, SparkApplication та TrainJob як вузли графа. Він малює ребра між підтримуваними ресурсами на основі .metadata.ownerReferences. Headlamp також показує вбудовані зведення для цих типів ресурсів, коли ви наводите на них курсор.
Спробуйте
README втулка Kubeflow пояснює встановлення та налаштування локального кластера, включаючи полегшений варіант лише з CRD для ознайомлення. Оскільки втулок виявляє встановлені API-групи, ви можете використовувати його з наявною модульною інсталяцією Kubeflow чи створити кластер для ознайомлення лише з CRD та зразковими ресурсами.
Застосуйте шаблон до інших платформ
Kubeflow ілюструє ширший шаблон. Платформи часто моделюють предметно-орієнтовані робочі процеси за допомогою власних ресурсів. Їхні інфопанелі зосереджені на цих робочих процесах, тоді як Kubernetes-оператори також потребують стану базових API-ресурсів та Podʼів. Втулок, що працює на основі CRD, у загальному Kubernetes UI може показувати цей стан, не змушуючи операторів перемикатися між незвʼязаними інструментами.
Втулок використовує ліцензію Apache 2.0 та розробляється під егідою Kubernetes SIG UI. Щоб повідомити про проблему чи зробити покращення, скористайтеся issue tracker чи pull requests репозиторію втулків Headlamp.
Представляємо втулок Cluster API для Headlamp
Headlamp — це відкритий, розширюваний проєкт Kubernetes SIG UI, призначений для огляду, керування та налагодження ресурсів кластера безпосередньо з вебоглядача.
Cluster API (CAPI) є субпроєктом Kubernetes, який надає декларативні API у стилі Kubernetes для керування життєвим циклом кластерів. Він дозволяє командам платформи створювати, оновлювати та керувати життєвим циклом кластерів Kubernetes за допомогою стандартних обʼєктів Kubernetes, збережених і узгоджених у кластері керування.
Керування ресурсами Cluster API історично вимагало використання команд kubectl та глибокого розуміння ієрархій власності. Втулок Headlamp Cluster API забезпечує візуальну ясність, швидше налагодження та спрощені операції для команд платформи безпосередньо всередині Headlamp.
Що надає цей втулок
Втулок Cluster API додає спеціальний розділ Cluster API до Headlamp і забезпечує повну видимість основних ресурсів CAPI через узгоджені списки та детальні перегляди.
| Можливість | Опис |
|---|---|
| Огляд кластерів | Перегляд кластерів з актуальним станом панелі управління та реплік робочих вузлів. |
| Видимість машин | Перевірка MachineDeployments, MachineSets, Machines та MachinePools зі станом та умовами. |
| Інфопанель Cluster API | Отримання централізованого огляду стану ресурсів Cluster API, активних проблем зі станами, інформації про провайдера та рекомендацій щодо усунення несправностей. |
| Моніторинг панелі управління | Відстеження реплік KubeadmControlPlane, версій та повʼязаних Machines. |
| Масштабування з інтерфейсу | Масштабування MachineDeployments та MachineSets безпосередньо з Headlamp. |
| Ієрархія підлеглих ресурсів | Відстеження взаємозвʼязків між кластерами, розгортаннями, наборами та машинами. |
| Перегляд KubeadmConfig | Перегляд конфігурацій завантаження, файлів, аргументів kubelet та налаштувань приєднання/ініціалізації. |
| Врахування топології | Автоматичне виявлення ресурсів, керованих ClusterClass, і призначення їм міток. |
| Мапа | Візуалізація взаємозвʼязків між Cluster, Control Plane та Worker. |
| Динамічне версіонування API | Підтримка обох версій Cluster API: v1beta1 та v1beta2. |
| Метрики Prometheus | Перегляд метрик наживо з втулка Headlamp Prometheus безпосередньо на сторінках деталей ресурсів Cluster API. |
Огляд втулка
Втулок Headlamp Cluster API надає основні ресурси Cluster API в узгодженому візуальному інтерфейсі всередині Headlamp. Ось деякі з ключових переглядів, включених у перший випуск.
Інфопанель Cluster API
Інфопанель надає централізований огляд ресурсів Cluster API та їх стану в кластері керування.
Огляд підсумовує стан кластерів, Machines, MachineDeployments, MachinePools, MachineSets та панелей управління. Він також виділяє поточні проблеми станів, інформацію про провайдера та кількість шаблонів конфігурацій, щоб допомогти операторам швидко виявляти деградовані або несправні ресурси.
Після вибору кластера відкривається детальний огляд стану, що показує стан панелі управління та робочих вузлів, інформацію про машини, деталі інфраструктури та стани ресурсів. Коли виявляються проблеми, панель надає рекомендації щодо усунення несправностей та діагностичні команди для допомоги у вирішенні проблем.
Забезпечте повну видимість Cluster API в Headlamp
Перегляд списку кластерів показує всі ресурси Cluster у кластері керування, включаючи стан реплік панелі управління та робочих вузлів. Це дає змогу швидко оцінити загальний стан кластера.
Перегляд деталей кластера надає інформацію про статус ресурсів, стани, посилання на інфраструктуру, посилання на панель керування та повʼязані Machines на одній сторінці.
Досліджуйте ресурси Cluster API у візуальному інтерфейсі
Для MachineDeployments, MachineSets, Machines та MachinePools доступні окремі перегляди. Ці сторінки відображають кількість реплік, відносини власності, ідентифікатори провайдерів, версії та стани для підтримки щоденних операцій та налагодження.
Масштабування робочих навантажень безпосередньо з Headlamp
MachineDeployments та MachineSets включають вбудовану дію масштабування, що дозволяє регулювати кількість реплік безпосередньо з Headlamp без використання команд терміналу.
Для кластерів із топологічним керуванням втулок також вказує, коли масштабування слід виконувати на рівні кластера.
Перегляд конфігурації bootstrap без сирого YAML
Конфігурації bootstrap можна переглядати у структурованому форматі, включаючи вбудовані файли, аргументи kubelet, додаткові томи та налаштування join або init. Це усуває необхідність вручну переглядати сирий YAML або Secret.
Візуалізація взаємозвʼязків кластера за допомогою мапи
Візуальна мапа показує взаємозвʼязки між Cluster, панеллю управління та робочими ресурсами. Це забезпечує швидший спосіб розуміння ієрархії власності та загальної структури кластера.
Інтеграція метрик Prometheus
Втулок Cluster API інтегрується з втулком Headlamp Prometheus, щоб показувати метрики безпосередньо на сторінках деталей ресурсів Cluster API.
Коли втулок Prometheus встановлено та налаштовано, метрики вбудовуються безпосередньо на сторінках деталей для Cluster, MachineDeployments, MachineSets та Machines. Ви можете переглядати стан ресурсів та дані про продуктивність разом із станами та відносинами власності, не переходячи на окрему панель.
Це спрощує зіставлення стану інфраструктури з поточними показниками під час налагодження або повсякденної експлуатації кластера — і все це безпосередньо в Headlamp.
Як використовувати
Дивіться plugins/cluster-api/README.md для інструкцій з встановлення та використання.
Розроблено під час програми LFX Mentorship
Цей втулок був розроблений в рамках програми CNCF LFX Mentorship в проєкті Headlamp. Програма наставництва надала можливість тісно співпрацювати зі спільнотою Headlamp під час створення можливостей для покращення керування Cluster API.
Основна увага приділялася не лише впровадженню можливостей, але й розумінню реальних проблем зручності використання під час операцій з Cluster API. Обговорення з наставниками та членами спільноти допомогли визначити напрямок розвитку втулка, покращити досвід використання та пріоритизувати можливості, найкорисніші для команд платформи.
Програма наставництва також надала цінний досвід участі у великих проєктах з відкритим кодом: співпраця із супровідниками, участь у дискусіях щодо дизайну, обробка відгуків про випуски та ітеративне вдосконалення можливостей на основі відгуків спільноти.
Робота над втулком триває, з додатковими покращеннями та можливостями, запланованими після початкового випуску Alpha.
Питання та відгуки
Це випуск Alpha, і відгуки спільноти безпосередньо впливають на подальший розвиток.
- Повідомлення про помилки: Створити issue
- Запити на нові можливості: Почати обговорення
- Внесок: PR вітаються
- Kubernetes Slack: Приєднатися до каналу #headlamp для питань та обговорень
Представляємо контролер готовності вузлів

У стандартній моделі Kubernetes придатність вузла для робочих навантажень залежить від єдиного бінарного стану «Ready» («Готовий»). Однак у сучасних середовищах Kubernetes вузли потребують складних інфраструктурних залежностей, таких як мережеві агенти, драйвери сховищ, прошивка GPU або спеціальні перевірки працездатності, щоб бути повністю готовими до роботи, перш ніж вони зможуть надійно обслуговувати Podʼи.
Сьогодні від імені проєкту Kubernetes я оголошую про запуск Node Readiness Controller. Цей проєкт впроваджує декларативну систему для керування taints вузлів, розширюючи захисні барʼєри готовності під час завантаження вузлів за межі стандартних станів. Динамічно керуючи taints на основі власних сигналів працездатності, контролер гарантує, що робочі навантаження розміщуються тільки на вузлах, які відповідають усім вимогам інфраструктури.
Навіщо потрібен контролер готовності вузлів?
Основний статус «Ready» вузлів Kubernetes часто є недостатнім для кластерів із складними вимогами до ініціалізації. Оператори часто стикаються з труднощами, намагаючись переконатися, що певні DaemonSets або локальні сервіси працюють належним чином, перш ніж вузол потрапить до пулу планування.
Контролер готовності вузлів заповнює цю прогалину, дозволяючи операторам визначати власні scheduling gates, адаптовані до конкретних груп вузлів. Це дозволяє застосовувати різні вимоги до готовності в гетерогенних кластерах, гарантуючи, наприклад, що вузли, оснащені GPU, приймають Podʼи тільки після перевірки спеціалізованих драйверів, тоді як вузли загального призначення дотримуються стандартного шляху.
Він надає три основні переваги:
- Налаштовані визначення готовності: визначте, що означає готовий для вашої конкретної платформи.
- Автоматичне керування taints: контролер автоматично застосовує або видаляє taints вузлів залежно від статусу станів, запобігаючи потраплянню Podʼів на непідготовлену інфраструктуру.
- Декларативна ініціалізація вузлів: надійно керуйте багатоетапною ініціалізацією вузлів із чітким спостереженням за процесом ініціалізації.
Основні поняття та можливості
Контролер базується на API NodeReadinessRule (NRR), який дозволяє визначати декларативні gates для ваших вузлів.
Гнучкі режими виконання
Контролер підтримує два різних режими роботи:
- Безперервне виконання
- Активно підтримує гарантію готовності протягом усього життєвого циклу вузла. Якщо критична залежність (наприклад, драйвер пристрою) пізніше дає збій, на вузол негайно додається taint, щоб запобігти новому плануванню.
- Виконання тільки під час завантаження
- Спеціально для одноразових кроків ініціалізації, таких як попереднє завантаження важких образів або підготовка обладнання. Після виконання умов контролер позначає завантаження як завершене і припиняє моніторинг цього конкретного правила для вузла.
Звітування про стани
Контролер реагує на стани вузлів (Node Conditions), а не виконує перевірки працездатності самостійно. Така роздільна конструкція дозволяє йому безперешкодно інтегруватися з іншими інструментами, що існують в екосистемі, а також із власними рішеннями:
- Node Problem Detector (NPD): використовуйте наявні налаштування NPD та власні скрипти для звітування про стан вузлів.
- Readiness Condition Reporter: легкий агент, наданий проєктом, який можна розгорнути для періодичної перевірки локальних HTTP-точок доступу та відповідного оновлення станів вузлів.
Операційна безпека з тестовим запуском
Впровадження нових правил готовності у всьому парку вузлів несе в собі певний ризик. Щоб його зменшити, режим тестового запуску (dry run) дозволяє операторам спочатку змоделювати вплив на кластер. У цьому режимі контролер записує в логи заплановані дії та оновлює статус правила, щоб показати вузли, на які це вплине, без фактичного застосування taints, що дозволяє безпечно перевірити правило перед застосуванням.
Приклад: ініціалізація CNI
Наведене нижче правило NodeReadinessRule гарантує, що вузол залишатиметься таким, що не підлягає плануванню, доки його агент CNI не почне функціонувати. Контролер відстежує власний стан cniplugin.example.net/NetworkReady і видаляє taint readiness.k8s.io/acme.com/network-unavailable лише тоді, коли статус стає True.
apiVersion: readiness.node.x-k8s.io/v1alpha1
kind: NodeReadinessRule
metadata:
  name: network-readiness-rule
spec:
  conditions:
    - type: "cniplugin.example.net/NetworkReady"
      requiredStatus: "True"
  taint:
    key: "readiness.k8s.io/acme.com/network-unavailable"
    effect: "NoSchedule"
    value: "pending"
  enforcementMode: "bootstrap-only"
  nodeSelector:
    matchLabels:
      node-role.kubernetes.io/worker: ""
Демо:
Приєднуйтесь
Node Readiness Controller тільки починає свою роботу, і ми випустили перші версії. Зараз ми чекаємо на відгуки від спільноти, щоб вдосконалити план розвитку. Після плідних дискусій на Unconference під час KubeCon NA 2025 ми з радістю продовжимо розмову віч-на-віч.
Приєднуйтесь до нас на KubeCon + CloudNativeCon Europe 2026 на сесії треку супровідників: Вирішення проблеми недетермінованого планування: представлення Node Readiness Controller.
Тим часом ви можете долучитися до нашої роботи або стежити за нашими досягненнями тут:
- GitHub: https://sigs.k8s.io/node-readiness-controller
- Slack: долучіться до обговорення в #sig-node-readiness-controller
- Документація: Початок роботи
Експерименти з Gateway API за допомогою kind
Цей документ проведе вас через налаштування локального експериментального середовища з Gateway API з використанням kind. Це середовище розроблено для навчання та тестування. Воно допомагає вам зрозуміти концепції Gateway API без складності промислового середовища.
Увага:
Це експериментальне навчальне середовище, яке не слід використовувати в промисловому середовищі. Компоненти, використані в цьому документі, не придатні для промислового використання. Коли ви будете готові розгорнути Gateway API в промисловому середовищі, виберіть реалізацію, яка відповідає вашим потребам.Огляд
У цьому посібнику ви:
- Налаштуєте локальний кластер Kubernetes за допомогою kind (Kubernetes in Docker)
- Розгорнете cloud-provider-kind, який надає як LoadBalancer Services, так і контролер Gateway API
- Створите Gateway і HTTPRoute для маршрутизації трафіку до демо-застосунку
- Протестуєте вашу конфігурацію Gateway API локально
Це середовище ідеально підходить для навчання, розробки та експериментування з концепціями Gateway API.
Передумови
Перед початком переконайтеся, що у вас встановлено наступне на локальному компʼютері:
- Docker — потрібен для запуску kind та cloud-provider-kind
- kubectl — інструмент командного рядка Kubernetes
- kind — Kubernetes in Docker
- curl — потрібен для тестування маршрутів
Створення кластера kind
Створіть новий кластер kind, запустивши:
kind create cluster
Це створить одновузловий кластер Kubernetes, який працює в контейнері Docker.
Встановлення cloud-provider-kind
Далі вам потрібен cloud-provider-kind, який надає два ключові компоненти для цього середовища:
- Контролер LoadBalancer, який призначає адреси Service типу LoadBalancer
- Контролер Gateway API, який реалізує специфікацію Gateway API
Він також автоматично встановлює Custom Resource Definitions (CRDs) Gateway API у вашому кластері.
Запустіть cloud-provider-kind як контейнер Docker на тому ж хості, де ви створили кластер kind:
VERSION="$(basename $(curl -s -L -o /dev/null -w '%{url_effective}' https://github.com/kubernetes-sigs/cloud-provider-kind/releases/latest))"
docker run -d --name cloud-provider-kind --rm --network host -v /var/run/docker.sock:/var/run/docker.sock registry.k8s.io/cloud-provider-kind/cloud-controller-manager:${VERSION}
Примітка: На деяких системах можуть знадобитися підвищені привілеї для доступу до сокета Docker.
Перевірте, що cloud-provider-kind запущений:
docker ps --filter name=cloud-provider-kind
Ви повинні побачити контейнер у списку та в стані виконання. Ви також можете перевірити логи:
docker logs cloud-provider-kind
Експериментування з Gateway API
Тепер, коли ваш кластер налаштований, ви можете почати експериментування з ресурсами Gateway API.
cloud-provider-kind автоматично надає GatewayClass під назвою cloud-provider-kind. Ви будете використовувати цей клас для створення вашого Gateway.
Варто зауважити, що хоча kind не є хмарним провайдером, проєкт названий cloud-provider-kind, оскільки він надає можливості, які імітують хмарне середовище.
Розгортання Gateway
Наведений нижче маніфест:
- Створить новий простір імен
gateway-infra - Розгорне Gateway, який слухає на порту 80
- Прийматиме HTTPRoutes з іменами хостів, які відповідають шаблону
*.exampledomain.example - Дозволить маршрутам з будь-якого простору імен приєднуватися до Gateway. Примітка: У реальних кластерах використовуйте значення Same або Selector у полі
allowedRoutesnamespace selector, щоб обмежити приєднання.
Застосуйте наступний маніфест:
---
apiVersion: v1
kind: Namespace
metadata:
  name: gateway-infra
---
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: gateway
  namespace: gateway-infra
spec:
  gatewayClassName: cloud-provider-kind
  listeners:
  - name: default
    hostname: "*.exampledomain.example"
    port: 80
    protocol: HTTP
    allowedRoutes:
      namespaces:
        from: All
Потім перевірте, що ваш Gateway правильно запрограмований і має призначену адресу:
kubectl get gateway -n gateway-infra gateway
Очікуваний результат:
NAME      CLASS                 ADDRESS      PROGRAMMED   AGE
gateway   cloud-provider-kind   172.18.0.3   True         5m6s
Стовпець PROGRAMMED повинен показувати True, а поле ADDRESS повинно містити IP-адресу.
Розгортання демо-застосунку
Далі розгорніть простий echo-застосунок, який допоможе вам протестувати конфігурацію вашого Gateway. Цей застосунок:
- Слухає на порту 3000
- Повертає деталі запиту, включаючи шлях, заголовки та змінні середовища
- Запускається у просторі імен
demo
Застосуйте наступний маніфест:
apiVersion: v1
kind: Namespace
metadata:
  name: demo
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app.kubernetes.io/name: echo
  name: echo
  namespace: demo
spec:
  ports:
  - name: http
    port: 3000
    protocol: TCP
    targetPort: 3000
  selector:
    app.kubernetes.io/name: echo
  type: ClusterIP
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app.kubernetes.io/name: echo
  name: echo
  namespace: demo
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: echo
  template:
    metadata:
      labels:
        app.kubernetes.io/name: echo
    spec:
      containers:
      - env:
        - name: POD_NAME
          valueFrom:
            fieldRef:
              apiVersion: v1
              fieldPath: metadata.name
        - name: NAMESPACE
          valueFrom:
            fieldRef:
              apiVersion: v1
              fieldPath: metadata.namespace
        image: registry.k8s.io/gateway-api/echo-basic:v20251204-v1.4.1
        name: echo-basic
Створення HTTPRoute
Тепер створіть HTTPRoute для маршрутизації трафіку з вашого Gateway до echo-застосунку. Цей HTTPRoute буде:
- Реагувати на запити для імені хоста
some.exampledomain.example - Маршрутизувати трафік до echo-застосунку
- Приєднуватися до Gateway у просторі імен
gateway-infra
Застосуйте наступний маніфест:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: echo
  namespace: demo
spec:
  parentRefs:
  - name: gateway
    namespace: gateway-infra
  hostnames: ["some.exampledomain.example"]
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /
    backendRefs:
    - name: echo
      port: 3000
Тестування вашого маршруту
Завершальний крок — перевірка вашого маршруту за допомогою curl. Ви зробите запит на IP-адресу Gateway з іменем хоста some.exampledomain.example. Наступна команда підходить тільки для POSIX shell і може потребувати налаштування для вашого середовища:
GW_ADDR=$(kubectl get gateway -n gateway-infra gateway -o jsonpath='{.status.addresses[0].value}')
curl --resolve some.exampledomain.example:80:${GW_ADDR} http://some.exampledomain.example
Ви повинні отримати JSON-відповідь подібну до цієї:
{
 "path": "/",
 "host": "some.exampledomain.example",
 "method": "GET",
 "proto": "HTTP/1.1",
 "headers": {
  "Accept": [
   "*/*"
  ],
  "User-Agent": [
   "curl/8.15.0"
  ]
 },
 "namespace": "demo",
 "ingress": "",
 "service": "",
 "pod": "echo-dc48d7cf8-vs2df"
}
Якщо ви бачите цю відповідь, вітаємо! Ваше середовище Gateway API працює правильно.
Усунення несправностей
Якщо щось працює не так, як очікується, ви можете усунути несправності, перевіривши стан ваших ресурсів.
Перевірка стану Gateway
Спочатку перевірте ресурс Gateway:
kubectl get gateway -n gateway-infra gateway -o yaml
Перевірте стани в розділі status. Ваш Gateway повинен мати:
Accepted: True- Gateway був прийнятий контролеромProgrammed: True- Gateway був успішно налаштований.status.addressesзаповнений IP-адресою
Перевірка стану HTTPRoute
Далі перевірте ваш HTTPRoute:
kubectl get httproute -n demo echo -o yaml
Перевірте стани в розділі status.parents. Поширені проблеми включають:
- ResolvedRefs встановлено False з причиною
BackendNotFound; це означає, що Service бекенду не існує або має неправильне імʼя - Accepted встановлено False; це означає, що маршрут не міг приєднатися до Gateway (перевірте дозволи простору імен або відповідність імені хоста)
Приклад помилки, коли бекенд не знайдено:
status:
  parents:
  - conditions:
    - lastTransitionTime: "2026-01-19T17:13:35Z"
      message: backend not found
      observedGeneration: 2
      reason: BackendNotFound
      status: "False"
      type: ResolvedRefs
    controllerName: kind.sigs.k8s.io/gateway-controller
Перевірка логів контролера
Якщо стан ресурсів не допомагає виявити проблему, перевірте логи cloud-provider-kind:
docker logs -f cloud-provider-kind
Це покаже детальні логи як з контролерів LoadBalancer, так і Gateway API.
Очищення
Коли ви закінчите з експериментами, ви можете очистити ресурси:
Видалення ресурсів Kubernetes
Видаліть простори імен (це видалить усі ресурси в них):
kubectl delete namespace gateway-infra
kubectl delete namespace demo
Зупинка cloud-provider-kind
Зупиніть та видаліть контейнер cloud-provider-kind:
docker stop cloud-provider-kind
Оскільки контейнер був запущений з прапорцем --rm, він буде автоматично видалений при зупинці.
Видалення кластера kind
Нарешті, видаліть кластер kind:
kind delete cluster
Наступні кроки
Тепер, коли ви поекспериментували з Gateway API локально, ви готові дослідити готові до промислової експлуатації реалізації:
- Розгортання в промисловій експлуатації: Перегляньте реалізації Gateway API, щоб знайти контролер, який відповідає вашим вимогам до промислового середовища
- Дізнайтеся більше: Ознайомтеся з документацією Gateway API, щоб дізнатися про розширені можливості, такі як TLS, розподіл трафіку та маніпуляція заголовками
- Розширена маршрутизація: Експериментуйте з маршрутизацією на основі шляху, узгодженням заголовків, дзеркальним відображенням запитів та іншими можливостями, дотримуючись посібникам користувача Gateway API
Фінальне попередження
Це середовище kind призначене лише для розробки та навчання. Завжди використовуйте реалізацію Gateway API промислового рівня для реальних робочих навантажень.
Cluster API v1.12: Впровадження оновлень на місці та ланцюгових оновлень
Cluster API забезпечує декларативне керування життєвим циклом кластерів Kubernetes, дозволяючи користувачам і платформним командам визначати бажаний стан кластерів і покладатися на контролери, які постійно приводять кластери до нього.
Подібно до того, як ви можете використовувати StatefulSet або Deployment в Kubernetes для керування групою Podʼів, в Cluster API ви можете використовувати KubeadmControlPlane для керування набором машин панелі управління або MachineDeployments для керування групою робочих вузлів.
Випуск Cluster API v1.12.0 розширює можливості Cluster API, зменшуючи складності у звичайних операціях життєвого циклу завдяки впровадженню оновлень на місці та ланцюгових оновлень.
Акцент на простоті та зручності використання
З версією v1.12.0 проєкт Cluster API ще раз демонструє, що ця спільнота здатна запроваджувати велику кількість інновацій, одночасно мінімізуючи вплив на користувачів Cluster API.
Що це означає на практиці?
Користувачам просто потрібно змінити специфікацію Cluster або Machine (так само, як і в попередніх версіях Cluster API), і Cluster API автоматично запустить оновлення на місці або ланцюгові оновлення, коли це можливо і доцільно.
Оновлення на місці
Як і Kubernetes для Podʼів у Deployment, коли змінюється специфікація Machine, Cluster API також виконує розгортання, створюючи нову машину та видаляючи стару.
Цей підхід, навіяний принципом незмінної інфраструктури, має низку значних переваг:
- Він простий для пояснення, передбачуваний, послідовний і легкий для розуміння користувачами та інженерами.
- Він простий у реалізації, оскільки базується лише на двох основних операціях: створенні та видаленні.
- Реалізація не залежить від конкретних параметрів машини, таких як ОС, механізм завантаження тощо.
В результаті розгортання машин значно зменшують кількість змінних, які потрібно враховувати під час керування життєвим циклом хост-сервера, на якому розміщено вузли.
Однак, хоча переваги незмінності не підлягають обговоренню, як Kubernetes, так і Cluster API проходять подібний шлях, впроваджуючи зміни, що дозволяють користувачам мінімізувати порушення роботи навантажень, коли це можливо.
Згодом Cluster API також запровадив кілька вдосконалень до незмінних розгортань, зокрема:
- Підтримка поширення змін, що впливають тільки на ресурси Kubernetes, що дозволяє уникнути непотрібних розгортань
- Спосіб додавання taint PreferNoSchedule до застарілих вузлів, що дозволяє зменшити плинність Podʼів шляхом оптимізації перепланування Podʼів під час розгортань.
- Підтримка стратегії «спочатку видалити, потім розгорнути», що спрощує незмінні розгортання на фізичних серверах/у середовищах з обмеженими ресурсами.
Нова можливість оновлення на місці в Cluster API є наступним кроком на цьому шляху.
З випуском версії 1.12.0 Cluster API впроваджує підтримку розширень оновлення, що дозволяє користувачам вносити зміни в діючі машини на місці, без видалення та повторного створення машин.
Як KubeadmControlPlane, так і MachineDeployments підтримують оновлення на місці на основі нового розширення оновлення, а це означає, що межі можливостей Cluster API тепер значно змінилися.
Як працюють оновлення на місці?
Найпростіше пояснити це так: коли користувач запускає оновлення, змінюючи бажаний стан машин, Cluster API вибирає найкращий інструмент для досягнення бажаного стану.
Новина полягає в тому, що тепер Cluster API може вибирати між незмінними розгортаннями та розширеннями оновлень на місці для виконання необхідних змін.

Важливо, що це не незмінні розгортання проти оновлень на місці; Cluster API розглядає обидва варіанти як дійсні та вибирає найбільш відповідний механізм для даної зміни.
З точки зору супровідників Cluster API, оновлення на місці найбільш корисні для внесення змін, які не вимагають drain вузла або перезапуску Podʼів; наприклад: зміна облікових даних користувача для машини. З іншого боку, коли робоче навантаження все одно буде порушено, просто виконайте розгортання.
Тим не менш, Cluster API залишається вірним своїй розширюваній природі, і кожен може створити власне розширення оновлення та вирішити, коли і як використовувати оновлення на місці, обмінявши деякі переваги незмінних розгортань.
Щоб глибше ознайомитися з цією функцією, обовʼязково відвідайте сесію Оновлення на місці з Cluster API: золота середина між незмінною та змінною інфраструктурою на KubeCon EU в Амстердамі!
Ланцюгові оновлення
ClusterClass та керовані топології в Cluster API спільно забезпечили потужну та ефективну структуру, яка слугує будівельним блоком для багатьох платформ, що пропонують Kubernetes-as-a-Service.
Тепер, з версією v1.12.0, ця можливість робить ще один важливий крок вперед, дозволяючи користувачам оновлюватися більш ніж на одну мінорну версію Kubernetes за одну операцію, що зазвичай називається ланцюговим оновленням.
Це дозволяє користувачам вказати цільову версію Kubernetes і доручити Cluster API безпечно координувати необхідні проміжні кроки, замість того, щоб вручну керувати кожним мінорним оновленням.
Найпростіший спосіб пояснити, як працюють ланцюгові оновлення, полягає в тому, що після того, як користувач запускає оновлення, змінюючи бажану версію для кластера, Cluster API обчислює план оновлення, а потім починає його виконувати. Замість того, щоб (наприклад) оновлювати кластер до v1.33.0, потім до v1.34.0, а потім до v1.35.0, перевіряючи прогрес на кожному кроці, ланцюгове оновлення дозволяє перейти безпосередньо до v1.35.0.
Виконання плану оновлення означає оновлення панелі управління та робочих машин у суворо контрольованому порядку, повторюючи цей процес стільки разів, скільки потрібно для досягнення бажаного стану. Cluster API тепер здатний керувати цим за вас.
Cluster API дбає про оптимізацію та мінімізацію кроків оновлення для робочих машин, і фактично робочі машини пропускатимуть оновлення до проміжних мінорних випусків Kubernetes, коли це дозволяють політики розбіжності версій Kubernetes.

Також у цьому випадку розширюваність є основою цієї можливості, і runtime-розширення плану оновлення можуть бути використані для впливу на те, як обчислюється план оновлення; аналогічно, хуки життєвого циклу можуть використовуватися для автоматизації інших завдань, які необхідно виконати під час оновлення, наприклад, оновлення надбудови після завершення оновлення панелі управління.
На наш погляд, ланцюгові оновлення найбільш корисні для користувачів, яким важко встигати за мінорними релізами Kubernetes і які, наприклад, хочуть оновлюватися лише раз на рік, а потім оновлюватися на три версії (n-3 → n). Але майте на увазі: те, що тепер ви можете легко оновлюватися більш ніж на одну мінорну версію, не є приводом для того, щоб не встановлювати регулярно патчі у свій кластер!
Команда випуску
Я хотів би подякувати всім учасникам, супровідникам та інженерам, які добровільно долучилися до команди випуску.
Надійність та передбачуваність випусків Cluster API, що є однією з найбільш цінованих можливостей нашими користувачами, можлива лише завдяки підтримці, відданості та наполегливій праці спільноти.
Висловлюємо подяку всій спільноті Cluster API за випуск версії 1.12.0 та всі чудові випуски, представлені у 2025 році! Якщо ви зацікавлені у співпраці, ознайомтеся з рекомендаціями щодо співпраці з Cluster API.
Що далі?
Якщо ви прочитаєте Маніфест Cluster API, то побачите, як в рамках субпроєкту Cluster API проголошується право залишатися незавершеним, визнаючи необхідність постійного розвитку, вдосконалення та адаптації до мінливих потреб користувачів Cluster API та ширшої екосистеми Cloud Native.
Оскільки Kubernetes продовжує розвиватися, субпроєкт Cluster API буде просуватися разом з ним, зосереджуючись на безпечніших оновленнях, зменшенні порушень та зміцненні будівельних блоків для платформ, що керують Kubernetes у великих масштабах.
Інновації залишаються в центрі уваги Cluster API, тож чекайте на насичений подіями 2026 рік!
Корисні посилання:
Kubernetes v1.35: allowList для exec-втулків у kuberc обмежує виконувані файли, які запускає kubeconfig
Чи знали ви, що kubectl може запускати довільні виконувані файли, включаючи скрипти оболонки, з повними правами користувача, який їх викликає, і навіть без вашого відома? Кожного разу, коли ви завантажуєте або автоматично генеруєте kubeconfig, поле users[n].exec.command може вказати виконуваний файл для отримання облікових даних від вашого імені. Не зрозумійте мене неправильно, це неймовірна можливість, яка дозволяє вам пройти автентифікацію в кластері за допомогою зовнішніх постачальників ідентифікації. Проте, ви, мабуть, бачите проблему: чи знаєте ви точно, які виконувані файли ваш kubeconfig запускає у вашій системі? Чи довіряєте ви конвеєру, який згенерував ваш kubeconfig? Якщо на код, що генерує kubeconfig, було здійснено атаку на ланцюжок постачання, або якщо конвеєр генерації було скомпрометовано, зловмисник може робити неприємні речі з вашою машиною, змушуючи ваш kubeconfig виконувати довільний код.
Щоб надати користувачам більше контролю над тим, що виконується в їхній системі, SIG-Auth та SIG-CLI додали політику втулків для облікових даних та список дозволених елементів як бета-можливість до Kubernetes 1.35. Це доступно для всіх клієнтів, які використовують бібліотеку client-go, шляхом заповнення структури ExecProvider.PluginPolicy у конфігурації REST. Щоб розширити вплив цієї зміни, Kubernetes v1.35 також дозволяє керувати цим без написання жодного рядка коду застосунку. Ви можете налаштувати kubectl для застосування політики та списку дозволеного, додавши два поля до файлу конфігурації kuberc: credentialPluginPolicy та credentialPluginAllowlist. Додавання одного або обох цих полів обмежує втулки облікових даних, які kubectl може виконувати.
Як це працює
Повний опис цієї функціональності доступний в нашій офіційній документації до kuberc, але в цьому блозі ми надамо короткий огляд нових налаштувань безпеки. Нові можливості перебувають на стадії бета і доступні без увімкнення будь-яких функціональних можливостей.
Наступний приклад є найпростішим: просто не вказуйте нові поля.
apiVersion: kubectl.config.k8s.io/v1beta1
kind: Preference
Це дозволить kubectl працювати як і раніше, а всі втулки будуть дозволені.
Наступний приклад функціонально ідентичний, але він є чіткішим і тому кращим, якщо це саме те, що вам потрібно:
apiVersion: kubectl.config.k8s.io/v1beta1
kind: Preference
credentialPluginPolicy: AllowAll
Якщо ви не знаєте, чи ви використовуєте exec-втулки облікових даних, спробуйте встановити політику на DenyAll:
apiVersion: kubectl.config.k8s.io/v1beta1
kind: Preference
credentialPluginPolicy: DenyAll
Якщо ви використовуєте втулки облікових даних, ви швидко зʼясуєте, що намагається виконати kubectl. Ви отримаєте помилку, подібну до наведеної нижче.
Unable to connect to the server: getting credentials: plugin "cloudco-login" not allowed: policy set to "DenyAll"
Якщо вам не вистачає інформації для усунення проблеми, збільште детальність логування під час виконання наступної команди. Наприклад:
# збільшити або зменшити детальність, якщо проблема все ще залишається незрозумілою
kubectl get pods --verbosity 5
Вибіркові дозволи для втулків
Що робити, якщо для щоденної роботи вам потрібен втулок cloudco-login? Саме для цього існує третій варіант політики — Allowlist. Щоб дозволити використання певного втулка, встановіть політику та додайте credentialPluginAllowlist:
apiVersion: kubectl.config.k8s.io/v1beta1
kind: Preference
credentialPluginPolicy: Allowlist
credentialPluginAllowlist:
  - name: /usr/local/bin/cloudco-login
  - name: get-identity
Ви помітите, що в allowlist є два записи. Один з них вказаний повним шляхом, а інший, get-identity, є лише базовим іменем. Коли ви вказуєте лише базове імʼя, повний шлях буде шукатися за допомогою exec.LookPath, який не розширює globbing і не обробляє символи-замінники. Globbing наразі не підтримується. Обидві форми (базове імʼя та повний шлях) є прийнятними, але повний шлях є кращим, оскільки він ще більше звужує діапазон дозволених бінарних файлів.
Майбутні вдосконалення
Наразі запис у списку дозволеного (allowlist) має лише одне поле, name. У майбутньому ми (Kubernetes SIG CLI) хочемо додати інші вимоги. Однією з корисних ідей є перевірка контрольної суми, за допомогою якої, наприклад, бінарний файл можна буде запустити, тільки якщо він має суму sha256 b9a3fad00d848ff31960c44ebb5f8b92032dc085020f857c98e32a5d5900ff9c і знаходиться за адресою /usr/bin/cloudco-login.
Інша можливість — дозволити лише бінарні файли, підписані одним із довірених ключів підпису.
Приєднуйтесь
Політика втулків облікових даних все ще перебуває на стадії розробки, і ми дуже зацікавлені у ваших відгуках. Ми хотіли б дізнатися, що вам подобається в ній і які проблеми ви хотіли б, щоб вона вирішувала. Або, якщо у вас є час, щоб долучитися до розробки одного з вищезазначених вдосконалень, це буде чудовим способом розпочати співпрацю з Kubernetes. Приєднуйтесь до обговорення в Slack:
Kubernetes v1.35: Кращий спосіб передачі токенів ServiceAccount до драйверів CSI
Якщо ви підтримуєте драйвер CSI, який використовує токени ServiceAccount, Kubernetes v1.35 приносить удосконалення, про яке вам варто знати. З моменту введення можливості TokenRequests, токени ServiceAccount, запитувані драйверами CSI, передавалися їм через поле volume_context. Хоча це працювало, це не ідеальне місце для конфіденційної інформації, і ми бачили випадки, коли токени випадково потрапляли в логи драйверів CSI.
Kubernetes v1.35 вводить рішення бета-версії для вирішення цієї проблеми:
Добровільне ввімкнення драйвером CSI отримання токенів ServiceAccount через поле Secrets.
Це дозволяє драйверам CSI отримувати токени ServiceAccount
через поле secrets у NodePublishVolumeRequest,
яке є відповідним місцем для конфіденційних даних у специфікації CSI.
Розуміння поточного підходу
Коли драйвери CSI використовують можливість TokenRequests, вони можуть запитувати токени ServiceAccount для ідентичності робочого навантаження, налаштовуючи поле TokenRequests у специфікації CSIDriver. Ці токени передаються драйверам як частина мапи атрибутів тому, використовуючи ключ csi.storage.k8s.io/serviceAccount.tokens.
Поле volume_context працює, але воно не призначене для конфіденційних даних. Через це виникають кілька викликів:
По-перше, інструмент protosanitizer, який використовують драйвери CSI, не розглядає контекст тому як конфіденційний, тому токени ServiceAccount можуть потрапити в логи, коли gRPC-запити логуються. Це сталося з CVE-2023-2878 у Secrets Store CSI Driver та CVE-2024-3744 у Azure File CSI Driver.
По-друге, кожен драйвер CSI, який хоче уникнути цієї проблеми, повинен реалізовувати власну логіку санітізації, що призводить до неузгодженості між драйверами.
Специфікація CSI вже має поле secrets у NodePublishVolumeRequest, яке призначене саме для такого роду конфіденційної інформації. Проблема полягає в тому, що ми не можемо просто змінити місце, де ми розміщуємо токени, без порушення роботи поточних драйверів CSI, які очікують їх у контексті тому.
Як працює механізм увімкнення
Kubernetes v1.35 вводить механізм увімкнення, який дозволяє драйверам CSI вибирати, як вони отримують токени ServiceAccount. Таким чином, поточні драйвери продовжують працювати як і раніше, а драйвери можуть перейти до більш відповідного поля secrets, коли будуть готові.
Драйвери CSI можуть встановити нове поле у своїй специфікації CSIDriver:
#
# УВАГА: це приклад конфігурації.
#          Не використовуйте це для власного кластера!
#
apiVersion: storage.k8s.io/v1
kind: CSIDriver
metadata:
  name: example-csi-driver
spec:
  # ... наявні поля ...
  tokenRequests:
  - audience: "example.com"
    expirationSeconds: 3600
  # Нове поле для ввімкнення доставки через secrets
  serviceAccountTokenInSecrets: true  # типово false
Поведінка залежить від поля serviceAccountTokenInSecrets:
Коли встановлено false (типово), токени розміщуються у VolumeContext з ключем csi.storage.k8s.io/serviceAccount.tokens, як і сьогодні.
Коли встановлено true, токени розміщуються лише у полі Secrets з тим самим ключем.
Про бета-реліз
Функціональна можливість CSIServiceAccountTokenSecrets типово увімкнена як для kubelet, так і для kube-apiserver. Оскільки поле serviceAccountTokenInSecrets типово має значення false, увімкнення функціональної можливості не змінює жодної поточної поведінки. Усі драйвери продовжують отримувати токени через контекст тому, якщо вони явно не ввімкнуть нову поведінку. Це пояснює, чому ми почувалися комфортно, починаючи з бета-версії, а не альфа.
Посібник для авторів драйверів CSI
Якщо ви підтримуєте драйвер CSI, який використовує токени ServiceAccount, ось як запровадити цю можливість.
Додавання резервної логіки
Спочатку оновіть код вашого драйвера, щоб перевіряти обидва місця на наявність токенів. Це робить ваш драйвер сумісним з обома підходами, старим і новим:
const serviceAccountTokenKey = "csi.storage.k8s.io/serviceAccount.tokens"

func getServiceAccountTokens(req *csi.NodePublishVolumeRequest) (string, error) {
    // Перевірити поле secrets спочатку (нова поведінка, коли драйвер увімкнув її)
    if tokens, ok := req.Secrets[serviceAccountTokenKey]; ok {
        return tokens, nil
    }

    // Повернення до контексту тому (поточна поведінка)
    if tokens, ok := req.VolumeContext[serviceAccountTokenKey]; ok {
        return tokens, nil
    }

    return "", fmt.Errorf("service account tokens not found")
}
Ця резервна логіка є зворотно сумісною та безпечною для випуску в будь-якій версії драйвера, навіть до оновлення кластерів до v1.35.
Послідовність розгортання
Автори драйверів CSI повинні дотримуватися певної послідовності під час впровадження цієї можливості, щоб уникнути порушення наявних томів.
Підготовка драйвера (може відбутися будь-коли)
Ви можете почати підготовку вашого драйвера прямо зараз, додавши резервну логіку, яка перевіряє як поле secrets, так і контекст тому на наявність токенів. Ця зміна коду є зворотно сумісною та безпечною для випуску в будь-якій версії драйвера, навіть до оновлення кластерів до v1.35. Ми заохочуємо вас додати цю логіку раніше, випускати релізи та навіть переносити її (backport) до гілок обслуговування, де це можливо.
Оновлення кластера та увімкнення можливості
Після того, як ваш драйвер має резервну логіку, ось безпечний порядок розгортання для увімкнення можливості в кластері:
- Завершити оновлення kube-apiserver до 1.35 або пізнішої версії
- Завершити оновлення kubelet до 1.35 або пізнішої версії на всіх вузлах
- Переконатися, що версія драйвера CSI з резервною логікою розгорнута (якщо не зроблено в фазі підготовки)
- Повністю завершити розгортання DaemonSet драйвера CSI на всіх вузлах
- Оновити ваш маніфест CSIDriver, щоб встановити
serviceAccountTokenInSecrets: true
Важливі обмеження
Найважливіше, що потрібно памʼятати, — це порядок у часі. Якщо ваш DaemonSet драйвера CSI та обʼєкт CSIDriver знаходяться в одному маніфесті або чарті Helm, вам потрібно два окремі оновлення. Спочатку розгорніть нову версію драйвера з резервною логікою, зачекайте завершення розгортання DaemonSet, потім оновіть специфікацію CSIDriver, щоб встановити serviceAccountTokenInSecrets: true.
Також не оновлюйте CSIDriver перед тим, як завершиться розгортання всіх Podʼів драйвера. Якщо ви це зробите, монтування томів зазнають невдачі на вузлах, які все ще працюють зі старою версією драйвера, оскільки ті Podʼи перевіряють лише контекст тому.
Чому це важливо
Впровадження цієї можливості допомагає в кількох аспектах:
- Це усуває ризик випадкового потрапляння токенів ServiceAccount у логи як частини контексту тому в gRPC-запитах
- Використовується призначене специфікацією CSI поле для конфіденційних даних, і це правильно
- Інструмент
protosanitizerавтоматично правильно обробляє поле secrets, тому вам не потрібні специфічні для драйвера обхідні шляхи - Це опціонально, тому ви можете мігрувати у власному темпі без порушення наявних розгортань
Заклик до дії
Ми (Kubernetes SIG Storage) заохочуємо авторів драйверів CSI впровадити цю можливість та надати відгуки про досвід міграції. Якщо у вас є думки щодо дизайну API або виникають будь-які проблеми під час впровадження, будь ласка, зверніться до нас у каналі #csi на Kubernetes Slack (для запрошення відвідайте https://slack.k8s.io/).
Ви можете стежити за KEP-5538, щоб відстежувати прогрес у наступних релізах Kubernetes.
Kubernetes v1.35: Розширені оператори tolerations для підтримки числових порівнянь (Alpha)
Багато кластерів Kubernetes у промисловому середовищі поєднують вузли на вимогу (вищий рівень SLA) та спотові вузли або вузли з можливістю витіснення (нижчий рівень SLA), щоб оптимізувати витрати й водночас зберегти надійність критичних робочих навантажень. Командам платформи потрібен безпечний типовий варіант, який тримає більшість робочих навантажень подалі від ризикованих потужностей і водночас дозволяє окремим робочим навантаженням явно погоджуватися на них із чіткими пороговими значеннями, як-от «Я можу толерувати вузли з імовірністю відмови до 5%».
Сьогодні taints і tolerations у Kubernetes можуть перевіряти збіг точних значень або наявність ключа, але не можуть порівнювати числові пороги. Вам довелося б створювати дискретні категорії taint, використовувати зовнішні контролери допуску або погоджуватися на неоптимальні рішення щодо розміщення.
У Kubernetes v1.35 ми представляємо розширені оператори tolerations (Extended Toleration Operators) як альфа-можливість. Це вдосконалення додає оператори Gt (більше ніж) і Lt (менше ніж) до spec.tolerations, що дозволяє ухвалювати рішення про планування на основі порогових значень і відкриває нові можливості для розміщення на основі SLA, оптимізації витрат і розподілу робочих навантажень з урахуванням продуктивності.
Розвиток tolerations
Історично Kubernetes підтримував два основні оператори tolerations:
Equal: toleration відповідає taint, якщо ключ і значення точно збігаютьсяExists: toleration відповідає taint, якщо ключ існує, незалежно від значення
Хоча ці оператори добре працювали для категорійних сценаріїв, для числових порівнянь їх було недостатньо. Починаючи з v1.35, ми усуваємо цю прогалину.
Розглянемо такі реальні ситуації:
- Вимоги SLA: планувати робочі навантаження з високою доступністю тільки на вузлах із ймовірністю відмови нижче певного порогу
- Оптимізація витрат: дозволити чутливим до витрат пакетним завданням виконуватися на дешевших вузлах, які перевищують певне значення вартості за годину
- Гарантії продуктивності: забезпечити, щоб чутливі до затримок застосунки виконувалися тільки на вузлах, де дискові IOPS або пропускна здатність мережі перевищують мінімальні пороги
Без операторів числового порівняння оператори кластерів мусили вдаватися до обхідних рішень, таких як створення декількох дискретних значень taint або використання зовнішніх контролерів допуску, жоден з яких не масштабується добре і не забезпечує гнучкості, необхідної для динамічного планування на основі порогових значень.
Навіщо розширювати tolerations замість використання NodeAffinity?
Ви можете запитати: NodeAffinity вже підтримує числові оператори порівняння, тож навіщо розширювати tolerations? Хоча NodeAffinity добре підходить для вираження вподобань Podʼів, taints і tolerations дають важливі операційні переваги:
- Орієнтованість на політику: NodeAffinity задається для кожного Podʼа окремо, тож кожне робоче навантаження має явно відмовлятися від ризикованих вузлів. Taints інвертують контроль — вузли оголошують свій рівень ризику, і лише Podʼи з відповідними tolerations можуть на них потрапити. Це дає безпечнішу типову поведінку: більшість Podʼів тримаються подалі від spot/preemptible вузлів, якщо явно не погодилися на них.
- Семантика виселення: NodeAffinity не вміє виселяти. Taints підтримують ефект
NoExecuteзtolerationSeconds, що дозволяє операторам виконувати drain і виселяти Podʼи, коли SLA вузла погіршується або спотові екземпляри отримують повідомлення про завершення роботи. - Ергономіка експлуатації: централізована політика на боці вузла узгоджується з іншими захисними taints, як-от disk-pressure і memory-pressure, що робить керування кластером інтуїтивнішим.
Це вдосконалення зберігає добре зрозумілу модель безпеки taints і tolerations, водночас уможливлюючи розміщення на основі порогових значень для планування з урахуванням SLA.
Представляємо оператори Gt та Lt
Kubernetes v1.35 представляє два нові оператори для tolerations:
Gt(більше ніж): toleration спрацьовує, якщо числове значення taint більше за значення tolerationLt(менше ніж): toleration спрацьовує, якщо числове значення taint менше за значення toleration
Коли Pod толерує taint з Lt, це означає: «Я можу толерувати вузли, де цей показник менший за мій поріг». Оскільки tolerations дозволяють планування, Pod може працювати на вузлах, де значення taint більше за значення toleration. Думайте про це так: «Я толерую вузли, які перевищують мої мінімальні вимоги».
Ці оператори працюють з числовими значеннями taint і дозволяють планувальнику приймати складні рішення щодо розміщення на основі безперервних метрик, а не дискретних категорій.
Примітка:
Числові значення для операторів Gt і Lt мають бути додатними 64-бітними цілими числами без нулів на початку. Наприклад, "100" є дійсним, але "0100" (з нулем на початку) і "0" (нульове значення) не допускаються.
Оператори Gt і Lt працюють з усіма ефектами taint: NoSchedule, NoExecute і PreferNoSchedule.
Випадки використання та приклади
Розгляньмо, як розширені оператори tolerations розвʼязують реальні завдання планування.
Приклад 1: Захист спотових екземплярів за допомогою порогових значень SLA
Багато кластерів поєднують вузли на вимогу та спотові вузли або вузли з можливістю витіснення для оптимізації витрат. Спотові вузли дають значну економію, але мають вищий рівень відмов. Ви хочете, щоб більшість робочих навантажень типово уникала спотових вузлів, і водночас дозволити окремим робочим навантаженням явно погоджуватися на них із чіткими межами SLA.
Спочатку додайте до спотових вузлів taint з їхньою ймовірністю відмови (наприклад, 15% відмов на рік):
apiVersion: v1
kind: Node
metadata:
  name: spot-node-1
spec:
  taints:
  - key: "failure-probability"
    value: "15"
    effect: "NoExecute"
Вузли на вимогу мають набагато нижчий рівень відмов:
apiVersion: v1
kind: Node
metadata:
  name: ondemand-node-1
spec:
  taints:
  - key: "failure-probability"
    value: "2"
    effect: "NoExecute"
Критичні робочі навантаження можуть задавати суворі вимоги до SLA:
apiVersion: v1
kind: Pod
metadata:
  name: payment-processor
spec:
  tolerations:
  - key: "failure-probability"
    operator: "Lt"
    value: "5"
    effect: "NoExecute"
    tolerationSeconds: 30
  containers:
  - name: app
    image: payment-app:v1
Цей Pod буде плануватися тільки на вузлах з failure-probability менше 5 (тобто ondemand-node-1 з 2%, але не spot-node-1 з 15%). Ефект NoExecute з tolerationSeconds: 30 означає, що якщо SLA вузла погіршується (наприклад, хмарний провайдер змінює значення taint), Pod отримує 30 секунд для коректного завершення роботи перед примусовим виселенням.
Тим часом відмовостійке пакетне завдання може явно погодитися на спотові екземпляри:
apiVersion: v1
kind: Pod
metadata:
  name: batch-job
spec:
  tolerations:
  - key: "failure-probability"
    operator: "Lt"
    value: "20"
    effect: "NoExecute"
  containers:
  - name: worker
    image: batch-worker:v1
Це пакетне завдання толерує вузли з імовірністю відмови до 20%, тому може виконуватися як на вузлах на вимогу, так і на спотових вузлах, максимально заощаджуючи кошти ціною вищого ризику.
Приклад 2: Розміщення робочих навантажень ШІ за рівнями GPU
Робочі навантаження ШІ та машинного навчання часто мають специфічні вимоги до обладнання. За допомогою розширених операторів tolerations ви можете створювати рівні GPU-вузлів і гарантувати, що робочі навантаження потраплять на обладнання відповідної потужності.
Додайте до вузлів GPU taint з їхнім показником обчислювальної потужності:
apiVersion: v1
kind: Node
metadata:
  name: gpu-node-a100
spec:
  taints:
  - key: "gpu-compute-score"
    value: "1000"
    effect: "NoSchedule"
---
apiVersion: v1
kind: Node
metadata:
  name: gpu-node-t4
spec:
  taints:
  - key: "gpu-compute-score"
    value: "500"
    effect: "NoSchedule"
Важке навчальне навантаження може вимагати високопродуктивних GPU:
apiVersion: v1
kind: Pod
metadata:
  name: model-training
spec:
  tolerations:
  - key: "gpu-compute-score"
    operator: "Gt"
    value: "800"
    effect: "NoSchedule"
  containers:
  - name: trainer
    image: ml-trainer:v1
    resources:
      limits:
        nvidia.com/gpu: 1
Це гарантує, що Pod для навчання плануватиметься лише на вузлах з показником обчислювальної потужності понад 800 (як-от вузол A100), і не потрапить на GPU нижчого рівня, які сповільнили б навчання.
Тим часом робочі навантаження інференсу з менш суворими вимогами можуть використовувати будь-який доступний GPU:
apiVersion: v1
kind: Pod
metadata:
  name: model-inference
spec:
  tolerations:
  - key: "gpu-compute-score"
    operator: "Gt"
    value: "400"
    effect: "NoSchedule"
  containers:
  - name: inference
    image: ml-inference:v1
    resources:
      limits:
        nvidia.com/gpu: 1
Приклад 3: Розміщення робочого навантаження з оптимізацією витрат
Для пакетної обробки або некритичних робочих навантажень ви можете мінімізувати витрати, запускаючи їх на дешевших вузлах, навіть якщо вони мають нижчі характеристики продуктивності.
До вузлів можна додати taint з їхнім рейтингом вартості:
spec:
  taints:
  - key: "cost-per-hour"
    value: "50"
    effect: "NoSchedule"
Чутливе до вартості пакетне завдання може задати, наскільки дорогі вузли воно готове толерувати:
tolerations:
- key: "cost-per-hour"
  operator: "Lt"
  value: "100"
  effect: "NoSchedule"
Це пакетне завдання плануватиметься на вузлах, що коштують менше 100 доларів за годину, і уникатиме дорожчих вузлів. У поєднанні з пріоритетами планування Kubernetes це дозволяє реалізувати складні стратегії розподілу за вартістю, за яких критичні робочі навантаження отримують преміум-вузли, а пакетні робочі навантаження ефективно використовують бюджетні ресурси.
Приклад 4: Розміщення на основі продуктивності
Застосунки з інтенсивним використанням сховища часто потребують гарантій мінімальної продуктивності диска. За допомогою розширених операторів tolerations ви можете забезпечити дотримання цих вимог на рівні планування.
tolerations:
- key: "disk-iops"
  operator: "Gt"
  value: "3000"
  effect: "NoSchedule"
Ця toleration гарантує, що Pod планується тільки на вузли, де disk-iops перевищує 3000. Оператор Gt означає «Мені потрібні вузли, у яких значення більше за цей мінімум».
Як використовувати цю можливість
Розширені оператори tolerations є альфа-можливістю в Kubernetes v1.35. Щоб спробувати її:
-
Увімкніть функціональну можливість на API-сервері та планувальнику:
--feature-gates=TaintTolerationComparisonOperators=true -
Додайте до вузлів taints з числовими значеннями метрик, важливих для ваших потреб планування:
kubectl taint nodes node-1 failure-probability=5:NoSchedule kubectl taint nodes node-2 disk-iops=5000:NoSchedule -
Використовуйте нові оператори у специфікаціях ваших Podʼів:
  spec:
    tolerations:
    - key: "failure-probability"
      operator: "Lt"
      value: "1"
      effect: "NoSchedule"
Примітка:
Оскільки це альфа-можливість, розширені оператори tolerations можуть змінитися в майбутніх випусках, тож у промислових середовищах їх слід використовувати обережно. Завжди спершу ретельно тестуйте їх у непромислових кластерах.Що далі?
Ця альфа-версія — лише початок. Збираючи відгуки від спільноти, ми плануємо:
- Додати підтримку виразів CEL (Common Expression Language) у tolerations і спорідненості вузлів (node affinity) для ще гнучкішої логіки планування, зокрема порівняння семантичних версій
- Поліпшити інтеграцію з автоматичним масштабуванням кластерів для планування потужностей з урахуванням порогових значень
- Перевести можливість у бета-версію, а згодом і в GA зі стабільністю, придатною для промислового використання
Нам особливо цікаво дізнатися про ваші випадки використання! Чи є у вас сценарії, в яких планування на основі порогових значень вирішило б проблеми? Чи є додаткові оператори або можливості, які ви хотіли б бачити?
Як долучитися
Розвиток цієї можливості веде спільнота SIG Scheduling. Приєднуйтесь до нас, щоб спілкуватися зі спільнотою та ділитися своїми ідеями й відгуками щодо цієї можливості та не тільки.
Звʼязатися із супровідниками цієї можливості можна тут:
- Slack: #sig-scheduling у Kubernetes Slack
- Список розсилки: kubernetes-sig-scheduling@googlegroups.com
З питаннями щодо розширених операторів tolerations звертайтеся до спільноти SIG Scheduling. Чекаємо на ваші відгуки!
Як дізнатися більше?
- Taints та Tolerations — основи
- Оператори числового порівняння — докладніше про використання операторів
GtіLt - KEP-5471: Extended Toleration Operators for Threshold-Based Placement
Kubernetes v1.35: Новий рівень ефективності завдяки перезапуску Podʼів на місці
У версії Kubernetes 1.35 представлено нову потужну можливість, яку давно чекали: змогу викликати повний перезапуск Podʼа на місці. Ця можливість, Restart All Containers (альфа-версія в 1.35), дозволяє ефективно скинути стан Podʼів порівняно з ресурсоємним підходом, що передбачає видалення та повторне створення всього Podʼа. Ця можливість особливо корисна для робочих навантажень AI/ML, дозволяючи розробникам застосунків зосередитися на основній логіці тренування, перекладаючи складні механізми обробки збоїв і відновлення на sidecar-контейнери та декларативну конфігурацію Kubernetes. За допомогою RestartAllContainers та інших запланованих вдосконалень Kubernetes продовжує додавати будівельні блоки для створення найбільш гнучких, надійних та ефективних платформ для робочих навантажень AI/ML.
Ця нова функціональність доступна після увімкнення функціональної можливості RestartAllContainersOnContainerExits. Ця альфа-можливість розширює можливість Правила перезапуску контейнерів, яка перейшла в бета-версію в Kubernetes 1.35.
Проблема: коли перезапуску одного контейнера недостатньо, а відтворення Podʼів занадто дороге
Kubernetes вже давно підтримує політики перезапуску на рівні Podʼів (restartPolicy) і, з недавнього часу, на рівні окремих контейнерів. Ці політики чудово підходять для обробки збоїв в одному ізольованому процесі. Однак багато сучасних застосунків мають більш складні взаємозалежності між контейнерами. Наприклад:
- Init-контейнер готує середовище, монтуючи том або створюючи файл конфігурації. Якщо основний контейнер застосунку пошкоджує це середовище, простого перезапуску цього контейнера недостатньо. Необхідно запустити весь процес ініціалізації заново.
- Watcher sidecar контролює стан системи. Якщо він виявляє невідновлюваний, але повторюваний стан помилки, він повинен ініціювати перезапуск основного контейнера застосунку з чистого аркуша.
- Sidecar, який керує віддаленим ресурсом, виходить з ладу. Навіть якщо sidecar перезапускається самостійно, основний контейнер може застрягнути, намагаючись отримати доступ до застарілого або пошкодженого зʼєднання.
У всіх цих випадках бажаною дією є перезапуск не одного контейнера, а всіх. Раніше єдиним способом досягти цього було видалення Podʼа і створення нового за допомогою контролера (наприклад, Job або ReplicaSet). Цей процес є повільним і дорогим, оскільки передбачає залучення планувальника, розподіл ресурсів вузлів та повторну ініціалізацію мережі та сховища.
Ця неефективність стає ще гіршою при обробці великомасштабних робочих навантажень AI/ML (>= 1000 вузлів з одним Podʼом на вузол). Загальною вимогою для цих синхронних робочих навантажень є те, що в разі виникнення збою (наприклад, збою вузла) всі Podʼи у групі повинні бути створені заново, щоб скинути стан перед відновленням навчання, навіть якщо всі інші Podʼи не були безпосередньо уражені збоєм. Одночасне видалення, створення та планування тисяч Podʼів створює величезне вузьке місце. Орієнтовні витрати, повʼязані з цією несправністю, можуть становити 100 000 доларів на місяць у вигляді втрачених ресурсів.
Для обробки цих збоїв у завданнях навчання AI/ML потрібна складна інтеграція, що зачіпає як фреймворк навчання, так і Kubernetes, які часто є нестабільними і трудомісткими. Ця можливість представляє рішення, нативне для Kubernetes, що покращує надійність системи і дозволяє розробникам застосунків зосередитися на основній логіці навчання.
Ще однією важливою перевагою перезапуску Podʼів на місці є те, що збереження Podʼів на призначених їм вузлах дозволяє проводити подальшу оптимізацію. Наприклад, можна реалізувати кешування на рівні вузлів, повʼязане з конкретною ідентичністю Podʼа, що неможливо, коли Podʼи без необхідності створюються заново на різних вузлах.
Представляємо дію RestartAllContainers
Щоб вирішити цю проблему, у Kubernetes v1.35 додано нову дію до правил перезапуску контейнерів: RestartAllContainers. Коли контейнер завершується у спосіб, що відповідає правилу з цією дією, kubelet ініціює швидкий перезапуск Podʼа на місці.
Цей перезапуск на місці є дуже ефективним, оскільки зберігає найважливіші ресурси Podʼа:
- UID, IP-адресу та мережевий простір імен Podʼа.
- Пісочницю Podʼа та будь-які підключені пристрої.
- Усі томи, включаючи
emptyDirта томи, змонтовані з PVC.
Після завершення всіх запущених контейнерів послідовність запуску Podʼа повторно виконується з самого початку. Це означає, що всі init-контейнери запускаються знову по порядку, а потім — sidecar-контейнери та звичайні контейнери, що забезпечує повністю новий старт у відомому надійному середовищі. За винятком ефемерних контейнерів (які завершуються), всі інші контейнери, включаючи ті, що раніше були успішними або невдалими, будуть перезапущені, незалежно від їхніх індивідуальних політик перезапуску.
Випадки використання
1. Ефективний перезапуск завдань ML/Batch
Для завдань навчання ML перепланування робочого Podʼа у разі збою є дорогою операцією, яка марнує цінні обчислювальні ресурси. На кластері навчання з 1000 вузлів накладні витрати на перепланування можуть призвести до втрати понад 100 000 доларів на обчислювальні ресурси щомісяця.
За допомогою дій RestartAllContainers ви можете вирішити цю проблему, увімкнувши набагато швидшу гібридну стратегію відновлення: відтворюйте лише «пошкоджені» Podʼи (наприклад, ті, що знаходяться на несправних вузлах), одночасно запускаючи RestartAllContainers для решти справних Podʼів. Тести показують, що це зменшує накладні витрати на відновлення з хвилин до декількох секунд.
Завдяки перезапуску на місці, watcher sidecar може контролювати основний процес навчання. Якщо він зустрічає конкретну помилку, яку можна повторити, watcher може вийти з призначеним кодом, щоб запустити швидке скидання робочого Podʼа, що дозволяє йому перезапуститися з останньої контрольної точки без залучення контролера Job. Ця можливість тепер нативно підтримується Kubernetes.
Детальніше про майбутній розвиток та можливості JobSet читайте в KEP-467 JobSet in-place restart.
apiVersion: v1
kind: Pod
metadata:
  name: ml-worker-pod
spec:
  restartPolicy: Never
  initContainers:
  # Цей init-контейнер буде перезапускатися при кожному перезапуску на місці.
  - name: setup-environment
    image: my-repo/setup-worker:1.0
  - name: watcher-sidecar
    image: my-repo/watcher:1.0
    restartPolicy: Always
    restartPolicyRules:
    - action: RestartAllContainers
      exitCodes:
        operator: In
        # Конкретний код виходу від watcher запускає повний перезапуск Podʼа.
        values: [88]
  containers:
  - name: main-application
    image: my-repo/training-app:1.0
2. Повторний запуск init-контейнерів для отримання чистого стану
Уявіть ситуацію, коли init-контейнер відповідає за отримання облікових даних або налаштування спільного тому. Якщо основний застосунок виходить з ладу, що призводить до пошкодження цього спільного стану, вам потрібно перезапустити init-контейнер.
Налаштувавши основний застосунок так, щоб він завершувався з певним кодом після виявлення такого пошкодження, ви можете запустити дію RestartAllContainers, гарантуючи, що init-контейнер забезпечить чисте налаштування перед перезапуском застосунку.
3. Обробка великої кількості подібних завдань
Іноді завдання найкраще виконувати у вигляді Podʼів. Кожне завдання вимагає чистого виконання. Завданням може бути бекенд ігрової сесії або обробка елементів черги. Якщо швидкість виконання завдань висока, запуск повного циклу створення, планування та ініціалізації Podʼів є надто дорогим, особливо якщо завдання можуть бути короткими. Можливість перезапустити всі контейнери з нуля дозволяє Kubernetes обробляти такі сценарії без використання спеціальних рішень або фреймворків.
Як користуватися
Щоб спробувати цю можливість, ви повинні увімкнути функціональну можливість RestartAllContainersOnContainerExits у компонентах кластера Kubernetes (API-сервер та kubelet) з Kubernetes v1.35+. Ця альфа-можливість розширює можливість ContainerRestartRules, яка перейшла в бета-версію в v1.35 та типово увімкнена.
Після увімкнення ви можете додати restartPolicyRules до будь-якого контейнера (init, sidecar або звичайного) та використовувати дію RestartAllContainers.
Можливість розроблена для зручного використання в наявних застосунках. Однак, якщо застосунок не відповідає певним рекомендаціям, це може спричинити проблеми для застосунку або інструментів спостереження. Увімкнувши цю можливість, переконайтеся, що всі контейнери є такими, що можуть бути повторно запущені, і що зовнішні інструменти готові до повторного запуску init-контейнерів. Крім того, під час перезапуску всіх контейнерів kubelet не запускає хуки preStop. Це означає, що контейнери повинні бути створені таким чином, щоб витримувати раптове завершення роботи, не покладаючись на хуки preStop для належного завершення роботи.
Спостереження за перезапуском
Щоб зробити цей процес спостережуваним, до статусу Podʼа додається нова умова AllContainersRestarting. Коли перезапуск ініційовано, ця умова стає True і повертається до False, коли всі контейнери завершили роботу і Pod готовий розпочати свій життєвий цикл заново. Це забезпечує чіткий сигнал для користувачів та інших компонентів кластера про стан Podʼа.
Усі контейнери, перезапущені за допомогою цієї дії, матимуть збільшений лічильник перезапусків у статусі контейнера.
Дізнайтеся більше
- Прочитайте офіційну документацію про життєвий цикл Podʼів.
- Прочитайте детальну пропозицію в KEP-5532: Перезапуск усіх контейнерів при виході з контейнера.
- Прочитайте пропозицію щодо перезапуску JobSet на місці в JobSet issue #467.
Ми хочемо почути вашу думку!
Як альфа-можливість, RestartAllContainers готова до експериментів, і будь-які випадки використання та відгуки вітаються. Ця можливість розробляється спільнотою SIG Node. Якщо ви зацікавлені долучитися, поділитися своїми думками або зробити внесок, будь ласка, приєднуйтеся до нас!
Ви можете звʼязатися з SIG Node через:
- Slack: #sig-node
- Mailing list
7 типових помилок Kubernetes (і як я навчився їх уникати)
Не секрет, що Kubernetes може бути як потужним, так і іноді викликати розчарування. Коли я вперше почав займатися оркеструванням контейнерів, я зробив більше ніж достатньо помилок, щоб скласти цілий список підводних каменів. У цій публікації я хочу розглянути сім основних підводних каменів, з якими я стикався (або бачив, як стикалися інші), і поділитися кількома порадами, як їх уникнути. Незалежно від того, чи ви тільки починаєте знайомитися з Kubernetes, чи вже керуєте кластерами у промисловій експлуатації, сподіваюся, ці поради допоможуть вам уникнути зайвого стресу.
1. Оминання запитів на ресурси та обмежень
Пастка: відсутність вказання вимог до CPU та памʼяті в специфікаціях Podʼів. Зазвичай це відбувається тому, що Kubernetes не вимагає заповнення цих полів, а робочі навантаження часто можуть запускатися та працювати без них, тож цей пропуск легко не помітити на ранніх етапах конфігурації або під час швидких циклів розгортання.
Контекст: У Kubernetes запити та обмеження ресурсів є критично важливими для ефективного керування кластерами. Запити ресурсів гарантують, що планувальник зарезервує відповідну кількість CPU та памʼяті для кожного Podʼа, гарантуючи, що він має необхідні ресурси для роботи. Обмеження ресурсів обмежують кількість CPU та памʼяті, яку може використовувати Pod, запобігаючи тому, щоб жоден окремий Pod не споживав надмірні ресурси та потенційно не позбавляв ресурсів інші Podʼи. Коли запити та обмеження ресурсів не встановлені:
- Нестача ресурсів: Podʼи можуть отримувати недостатньо ресурсів, що призводить до зниження продуктивності або збоїв. Це відбувається тому, що Kubernetes планує Podʼи на основі цих запитів. Без них планувальник може розмістити занадто багато Podʼів на одному вузлі, що призводить до конкуренції за ресурси та вузьких місць у продуктивності.
- Привласнення ресурсів: З іншого боку, без обмежень Pod може споживати більше, ніж йому належить, впливаючи на продуктивність і стабільність інших Podʼів на тому ж вузлі. Це може призвести до таких проблем, як виселення або знищення інших Podʼів за допомогою Out-Of-Memory (OOM) killer через брак доступної памʼяті.
Як уникнути цього:
- Почніть з помірних
requests(наприклад,100mCPU,128Miпамʼяті) і подивіться, як ваш застосунок поводиться. - Моніторте реальне використання та уточнюйте свої значення; HorizontalPodAutoscaler може допомогти автоматизувати масштабування на основі метрик.
- Слідкуйте за
kubectl top podsабо вашим інструментом логування/моніторингу, щоб переконатися, що ви не виділяєте забагато чи замало ресурсів.
Перевірка життям: На початку я ніколи не думав про обмеження памʼяті. Здавалося, що все гаразд на моєму локальному кластері. Потім, у більшому середовищі, Podʼи раз у раз отримували OOMKilled. Урок засвоєно. Для отримання детальних інструкцій щодо налаштування запитів і обмежень ресурсів для ваших контейнерів, будь ласка, зверніться до Призначення ресурсів памʼяті для контейнерів і Podʼів (частина офіційної документації Kubernetes).
2. Недооцінка проб життєздатності та готовності
Пастка: Розгортання контейнерів без явного визначення того, як Kubernetes повинен перевіряти їхню справність або готовність. Це зазвичай відбувається тому, що Kubernetes вважає контейнер "запущеним", поки процес всередині не завершився. Без додаткових сигналів Kubernetes припускає, що робоче навантаження функціонує, навіть якщо застосунок всередині не відповідає, ініціалізується або застряг.
Контекст: Проби життєздатності, готовності та запуску — це механізми, які Kubernetes використовує для моніторингу стану контейнерів та їх доступності.
- Liveness probes визначають, чи все ще працює застосунок. Якщо проба життєздатності не проходить, контейнер перезапускається.
- Readiness probes контролюють, чи готовий контейнер обслуговувати трафік. Поки проба готовності не пройде, контейнер видаляється з точок доступу Service.
- Startup probes допомагають відрізнити тривалі часи запуску від фактичних збоїв.
Як уникнути цього:
- Додайте просту HTTP
livenessProbe, щоб перевірити точку доступу справності (наприклад,/healthz), щоб Kubernetes міг перезапустити контейнер, якщо він перестане відповідати. - Використовуйте
readinessProbe, щоб трафік не потрапляв до вашого застосунку, поки той не прогріється. - Робіть проби простими. Надто складні перевірки можуть створити хибні сповіщення та непотрібні перезапуски.
Перевірка життям: Одного разу я забув про пробу готовності для вебсервісу, який потребував деякого часу для завантаження. Користувачі зверталися до нього передчасно, отримували дивні тайм-аути, і я витратив години на роздуми. Проба готовності на три рядки врятувала б ситуацію.
Детальні інструкції щодо налаштування проб життєздатності, готовності та запуску для контейнерів див. у розділі Налаштування проб життєздатності, готовності та запуску в офіційній документації Kubernetes.
3. «Ми просто переглянемо логи контейнерів» (відомі останні слова)
Пастка: Покладатися виключно на логи контейнерів, отримані за допомогою kubectl logs. Це часто відбувається тому, що команда є швидкою та зручною, і в багатьох налаштуваннях логи здаються доступними під час розробки або раннього усунення несправностей. Однак kubectl logs лише отримує логи з поточних або нещодавно завершених контейнерів, а ці логи зберігаються на локальному диску вузла. Як тільки контейнер видаляється, виселяється або вузол перезавантажується, файли логів можуть бути видалені або назавжди втрачені.
Як уникнути цього:
- Централізуйте логи за допомогою інструментів CNCF, таких як Fluentd або Fluent Bit, щоб агрегувати вихідні дані з усіх Podʼів.
- Використовуйте OpenTelemetry для уніфікованого перегляду логів, метрик і (за потреби) трейсів. Це дозволяє виявляти кореляції між подіями інфраструктури та поведінкою на рівні застосунків.
- Поєднуйте логи з метриками Prometheus, щоб відстежувати дані на рівні кластера разом із логами застосунків. Якщо вам потрібне розподілене трасування, розгляньте проєкти CNCF, такі як Jaeger.
Перевірка життям: Коли я вперше втратив логи Podʼа через швидкий перезапуск, я зрозумів, наскільки ненадійним може бути «kubectl logs» сам по собі. З того часу я налаштував належний конвеєр для кожного кластера, щоб уникнути втрати важливих підказок.
4. Однакове ставлення до середовищ розробки та промислової експлуатації
Пастка: Розгортання тих самих маніфестів Kubernetes з ідентичними налаштуваннями в середовищах розробки, тестування та промислової експлуатації. Це часто відбувається, коли команди прагнуть до узгодженості та повторного використання, але не враховують, що специфічні для середовища фактори — такі як шаблони трафіку, доступність ресурсів, потреби в масштабуванні або контроль доступу — можуть суттєво відрізнятися. Без налаштування конфігурації, оптимізовані для одного середовища, можуть викликати нестабільність, погану продуктивність або прогалини в безпеці в іншому.
Як уникнути цього:
- Використовуйте оверлеї або kustomize, щоб підтримувати спільну базу, налаштовуючи запити ресурсів, репліки або конфігурацію для кожного середовища.
- Витягніть специфічну для середовища конфігурацію в ConfigMap і / або Secret. Ви можете використовувати спеціалізований інструмент, такий як Sealed Secrets, для керування конфіденційними даними.
- Плануйте масштабування в промисловому середовищі. Ваш кластер розробки, ймовірно, може обійтися мінімальними ресурсами CPU/памʼяті, але промислове середовище може потребувати значно більше.
Перевірка життям: Одного разу я збільшив replicaCount з 2 до 10 у невеликому середовищі розробки, просто щоб «перевірити». Я швидко вичерпав ресурси і півдня витратив на подолання наслідків. Ой.
5. Коли старі речі залишаються на місці
Пастка: У кластері залишаються невикористані або застарілі ресурси, такі як Deployment, Service, ConfigMap або PersistentVolumeClaim. Це часто відбувається тому, що Kubernetes не видаляє ресурси автоматично, якщо не вказано явно, і немає вбудованого механізму для відстеження приналежності або терміну придатності. З часом ці забуті обʼєкти можуть накопичуватися, споживаючи ресурси кластера, збільшуючи витрати на хостинг у хмарі та створюючи операційну плутанину, особливо коли застарілі Service або LoadBalancer продовжують маршрутизувати трафік.
Як уникнути цього:
- Позначте все мітками з метою або власником. Таким чином, ви зможете легко знайти ресурси, які вам більше не потрібні.
- Регулярно перевіряйте свій кластер: запустіть
kubectl get all -n <namespace>, щоб побачити, що насправді працює, і підтвердити, що все це так має бути. - Використовуйте збір сміття в Kubernetes: документація K8s показує, як автоматично видаляти залежні обʼєкти.
- Використовуйте автоматизацію політики: Інструменти, такі як Kyverno, можуть автоматично видаляти або блокувати застарілі ресурси після певного періоду, або впроваджувати політики життєвого циклу, щоб вам не доводилося памʼятати про кожен окремий крок очищення.
Перевірка життям: Після хакатону я забув знести «test-svc», привʼязаний до зовнішнього балансувальника навантаження. Три тижні потому я зрозумів, що платив за цей балансувальник навантаження весь цей час. Facepalm.
6. Занадто глибоке занурення в мережу занадто рано
Пастка: Впровадження розширених мережевих рішень, таких як service mesh, власні втулки CNI або міжкластерна комунікація, до повного розуміння нативних мережевих примітивів Kubernetes. Це часто трапляється, коли команди реалізують такі можливості, як маршрутизація трафіку, спостережуваність або mTLS, використовуючи зовнішні інструменти, не освоївши спочатку, як працює основна мережа Kubernetes: включаючи комунікацію Pod-to-Pod, Service типу ClusterIP, DNS-резолюцію та базову обробку вхідного трафіку. В результаті проблеми, повʼязані з мережею, стають важчими для усунення, особливо коли оверлеї вводять додаткові абстракції та точки відмови.
Як уникнути цього:
- Почніть з малого: Deployment, Service та базовий контролер Ingress, наприклад, на основі NGINX (наприклад, Ingress-NGINX).
- Переконайтеся, що ви розумієте, як трафік проходить у кластері, як працює виявлення сервісів і як налаштована DNS.
- Переходьте до повноцінного service mesh або розширених можливостей CNI лише тоді, коли це дійсно необхідно, оскільки складна мережа додає накладні витрати.
Перевірка життям: Я спробував Istio на невеликому внутрішньому застосунку, а потім витратив більше часу на налагодження самого Istio, ніж на сам застосунок. Врешті-решт, я відступив, видалив Istio, і все запрацювало нормально.
7. Занадто легковажне ставлення до безпеки та RBAC
Пастка: Розгортання робочих навантажень з ненадійними конфігураціями, такими як запуск контейнерів від імені користувача root, використання теґу образів latest, відключення контекстів безпеки або призначення надто широких ролей RBAC, таких як cluster-admin. Ці практики зберігаються, оскільки Kubernetes не забезпечує суворих типових налаштувань безпеки, а платформа розроблена для гнучкості, а не для жорстких обмежень. Без явних політик безпеки кластери можуть залишатися вразливими до ризиків, таких як втеча контейнерів, несанкціоноване підвищення привілеїв або випадкові зміни в промисловому середовищі через незафіксовані образи.
Як уникнути цього:
- Використовуйте RBAC для визначення ролей і дозволів у Kubernetes. Хоча RBAC є типовим і найширше підтримуваним механізмом авторизації, Kubernetes також дозволяє використовувати альтернативні авторизатори. Для більш складних або зовнішніх потреб у політиці розгляньте рішення, такі як OPA Gatekeeper (на основі Rego), Kyverno або власні вебхуки з використанням мов політики, таких як CEL або Cedar.
- Привʼяжіть образи до конкретних версій (більше ніякого
:latest!). Це допоможе вам знати, що насправді розгорнуто. - Розгляньте Pod Security Admission (або інші рішення, такі як Kyverno), щоб забезпечити використання контейнерів без прав root, файлових систем лише для читання тощо.
Перевірка життям: Я ніколи не стикався з серйозними порушеннями безпеки, але чув безліч застережливих історій. Якщо не посилити заходи безпеки, то це лише питання часу, коли щось піде не так.
І на останок
Kubernetes дивовижний, але він не є провидцем, він не зробить магічно правильні речі, якщо ви не скажете йому, що вам потрібно. Памʼятаючи про ці пастки, ви уникнете головного болю та марної трати часу. Помилки трапляються (повірте, я зробив свою частку), але кожна з них — це можливість дізнатися більше про те, як Kubernetes насправді працює під капотом. Якщо ви хочете заглибитися, офіційна документація та Slack спільноти є відмінними наступними кроками. І, звичайно, не соромтеся ділитися своїми жахливими історіями або порадами щодо успіху, адже в кінцевому підсумку ми всі разом у цій хмарно-орієнтованій пригоді.
Вдалих розгортань!
Попередній огляд Kubernetes v1.34
Kubernetes v1.34 очікукється наприкінці серпня 2025 року. Хоча він не міститиме видалень чи застарівань, у ньому буде велика кількість покращень. Ось деякі з функцій, які нас найбільше зацікавили в цьому циклі!
Зверніть увагу, що ця інформація відображає поточний стан розробки v1.34 і може змінитися до випуску нової версії.
Основні покращення Kubernetes v1.34
Нижче наведено деякі з помітних покращень, які, ймовірно, будуть включені до випуску v1.34, але це не вичерпний перелік усіх запланованих змін, і вміст релізу може змінюватися.
Ядро DRA переходить у стабільний стан
Динамічний розподіл ресурсів (DRA) забезпечує гнучкий спосіб категоризації, подання заявок та використання пристроїв, таких як GPU або спеціалізоване обладнання, у вашому кластері Kubernetes.
З моменту випуску v1.30 DRA базується на заявках на пристрої із структурованими параметрами, які є непрозорими для ядра Kubernetes. Відповідна пропозиція (KEP-4381) щодо покращення, була створена під впливом концепцій динамічного виділення сховищ. DRA зі структурованими параметрами використовує набір допоміжних API-типів: ResourceClaim, DeviceClass, ResourceClaimTemplate та ResourceSlice у групі resource.k8s.io, а також розширює .spec для Pod новим полем resourceClaims. Ядро DRA планує перейти у стабільний стан у Kubernetes v1.34.
З DRA драйвери пристроїв та адміністратори кластерів визначають класи пристроїв, доступні для використання. Робочі навантаження можуть подавати заявки на пристрої із зазначенням класу пристроїв у запитах. Kubernetes виділяє відповідні пристрої для конкретних заявок і розміщує відповідні Podʼи на вузлах, які мають доступ до виділених пристроїв. Ця система забезпечує гнучку фільтрацію пристроїв за допомогою CEL, централізовану категоризацію пристроїв та спрощені запити Podʼів.
Після переходу цієї функції у стабільний стан API resource.k8s.io/v1 буде стандартно доступний.
Токени ServiceAccount для автентифікації для завантаження образів
Інтеграція токенів ServiceAccount для провайдерів облікових даних kubelet ймовірно досягне бета-стадії та буде стандартно увімкнена у Kubernetes v1.34. Це дозволяє kubelet використовувати ці токени для завантаження контейнерних образів з реєстрів, які потребують автентифікації.
Підтримка вже існує як alpha і відстежується у KEP-4412.
Alpha-інтеграція дозволяє kubelet використовувати короткострокові, токени ServiceAccount (з OIDC-сумісною семантикою) з автоматичною ротацією для автентифікації у реєстрі контейнерних образів. Кожен токен прив’язаний до відповідного Podʼа; механізм замінює потребу у довгострокових секретах для завантаження образів.
Впровадження цього підходу знижує ризики безпеки, підтримує ідентичність на рівні робочого навантаження та зменшує операційні витрати. Це наближає автентифікацію при завантаженні образів до сучасних практик.
Політика заміни Pod в Deployment
Після змін в Deployment завершення Podʼів може тривати певний час і споживати додаткові ресурси. У рамках KEP-3973 буде додано поле .spec.podReplacementPolicy (як alpha) для Deployment.
Якщо функція увімкнена у вашому кластері, ви зможете обрати одну з двох політик:
TerminationStarted- Створює нові Podʼи, як тільки старі починають процес завершення роботи, що прискорює оновлення, але може збільшити споживання ресурсів.
TerminationComplete- Чекає повного завершення роботи старих Podʼів перед створенням нових, що забезпечує контрольоване споживання ресурсів.
Ця функція робить поведінку Deployment більш передбачуваною, дозволяючи обирати, коли створювати нові Podʼи, під час оновлення чи масштабування. Це корисно для кластерів із обмеженими ресурсами або для навантажень із тривалим часом завершенням.
Очікується, що функція буде доступна як alpha і може бути увімкнена через функціональні можливості DeploymentPodReplacementPolicy та DeploymentReplicaSetTerminatingReplicas в API-сервері та kube-controller-manager.
Готовий до промислового використання трейсинг для kubelet та API Server
Для вирішення проблеми налагодження на рівні вузла шляхом зіставлення розрізнених логів, KEP-2831 забезпечує глибоке, контекстне розуміння роботи kubelet.
Функція інструментує критичні операції kubelet, особливо gRPC-виклики до Container Runtime Interface (CRI), використовуючи стандарт OpenTelemetry. Це дозволяє операторам візуалізувати весь життєвий цикл подій (наприклад, запуск Podʼів) для визначення джерел затримок та помилок. Найпотужніша частина — передача trace ID у запитах до контейнерного рушія, що дозволяє їм зв’язувати свої власні відрізки.
Це доповнюється паралельним покращенням, KEP-647, яке приносить такі ж можливості трейсингу до API-сервера Kubernetes. Разом ці покращення забезпечують більш цілісний, наскрізний огляд подій, спрощуючи пошук затримок та помилок від панелі управління до вузла. Обидві функції пройшли офіційний процес релізу Kubernetes. KEP-2831 був представлений як alpha у v1.25, а KEP-647 — як alpha у v1.22. Обидва були підвищені до beta у v1.27. У v1.34 планується, що вони перейдуть у стабільний стан.
PreferSameZone та PreferSameNode для розподілу трафіку у Service
Поле spec.trafficDistribution у Service дозволяє вказати переваги щодо маршрутизації трафіку до точок доступу Service.
KEP-3015 визнає застарілим PreferClose та додає два нових значення: PreferSameZone та PreferSameNode. PreferSameZone еквівалентний поточному PreferClose. PreferSameNode надає перевагу надсиланню трафіку до точок доступу на тому ж вузлі, що й клієнт.
Функція була представлена у v1.33 функціональною можливістю PreferSameTrafficDistribution. У v1.34 вона планує перейти у beta зі стандартним її увімкненням.
Підтримка KYAML: діалекту YAML для Kubernetes
KYAML — це безпечніша та менш неоднозначна підмножина YAML, спеціально розроблена для Kubernetes. Незалежно від версії Kubernetes, ви зможете використовувати KYAML для написання маніфестів чи Helm-чартів. Ви можете писати KYAML і передавати його як вхідні дані у будь-яку версію kubectl, оскільки всі KYAML-файли також є валідними YAML. З kubectl v1.34 очікується можливість запитувати вивід у форматі KYAML (kubectl get -o kyaml …). За бажанням, ви можете й надалі отримувати вихід у форматі JSON або YAML.
KYAML вирішує специфічні проблеми YAML та JSON. У YAML значущі пробіли вимагають уважності до відступів та вкладеності, а необов’язкове взяття рядків в лапки може призвести до неочікуваного приведення типів (наприклад, "The Norway Bug"). JSON не підтримує коментарі та має суворі вимоги до ком та ключів в лапках.
KEP-5295 представляє KYAML, який вирішує основні проблеми:
-
Обовʼязкове використання подвійних лапок для рядкових (string) значень
-
Не вказувати ключі в лапках, якщо вони не є потенційно неоднозначними
-
Завжди використовує
{}для відображень (асоціативних масивів) -
Завжди використовує
[]для списків
Це схоже на JSON, але на відміну від JSON, KYAML підтримує коментарі, дозволяє коми у кінці та не вимагає лапок для ключів.
Очікуємо, що KYAML буде представлений як новий формат виводу для kubectl v1.34. Як і для всіх цих функцій, жодна з них не гарантована; слідкуйте за оновленнями!
KYAML є і залишатиметься строгою підмножиною YAML, що гарантує можливість парсингу KYAML-документів будь-яким YAML-парсером. Kubernetes не вимагає спеціального формату KYAML для вхідних даних, і змінювати це не планується.
Точне регулювання автоматичного масштабування з налаштовуваною толерантністю HPA
KEP-4951 додає можливість налаштовувати толерантність автомасштабування для кожного HPA окремо, замість стандартного кластерного значення 10%, яке часто є занадто грубим для різних навантажень. Покращення додає необов’язкове поле tolerance до секцій spec.behavior.scaleUp та spec.behavior.scaleDown HPA, дозволяючи різні значення толерантності для масштабування вгору та вниз, що особливо корисно, оскільки чутливість до масштабування вгору зазвичай важливіша для обробки піків трафіку.
Функція була випущена як alpha у Kubernetes v1.33 з функціональною можливістю HPAConfigurableTolerance, а у v1.34 планує перейти у beta. Це покращення допомагає вирішити проблеми масштабування для великих розгортань, де толерантність для масштабування вниз на 10% може означати те, що в роботі залишаться сотні зайвих Podʼів. Новий підхід дозволяє оптимізувати поведінку для кожного навантаження окремо.
Хочете дізнатися більше?
Нові функції та застарівання також оголошуються у нотатках до релізу Kubernetes. Офіційний анонс новинок у Kubernetes v1.34 буде частиною CHANGELOG для цього випуску.
Випуск Kubernetes v1.34 заплановано на середу, 27 серпня 2025 року. Слідкуйте за оновленнями!
Долучайтеся
Найпростіший спосіб долучитися до Kubernetes — приєднатися до однієї з багатьох Special Interest Groups (SIG), які відповідають вашим інтересам. Маєте щось, чим хочете поділитися з Kubernetes-спільнотою? Висловіть свою думку на щотижневій community meeting та через канали нижче. Дякуємо за ваші відгуки та підтримку!
- Слідкуйте за нами у Bluesky @kubernetes.io для останніх новин
- Долучайтеся до обговорень на Discuss
- Долучайтеся до спільноти у Slack
- Ставте питання (або відповідайте на них) на Server Fault або Stack Overflow
- Поділіться своєю Kubernetes історією
- Читайте більше про події у Kubernetes на блозі
- Дізнайтеся більше про Kubernetes Release Team
Оголошення про випуск etcd v3.6.0
Це оголошення спочатку було опубліковане в блозі etcd.
Сьогодні ми випускаємо etcd v3.6.0, перший мінорний реліз з моменту випуску etcd v3.5.0 15 червня 2021 року. Цей реліз вводить кілька нових можливостей, робить значний прогрес у тривалих зусиллях, таких як підтримка зниження версії та міграція на v3store, і вирішує численні критичні та основні проблеми. Він також включає великі оптимізації в використанні памʼяті, покращуючи ефективність і продуктивність.
На додачу до можливостей v3.6.0, etcd приєднався до Kubernetes як SIG (sig-etcd), що дозволяє нам покращити стійкість проєкту. Ми впровадили систематичне тестування на надійність, щоб забезпечити правильність і надійність. За допомоги робочої групи etcd-operator ми плануємо також покращити зручність використання.
Далі наведені найзначніші зміни в etcd v3.6.0, а також обговорення планів майбутнього розвитку. Для детального списку змін, будь ласка, зверніться до CHANGELOG-3.6.
Щира подяка всім учасникам, які зробили цей реліз можливим!
Безпека
etcd ставиться до безпеки серйозно. Щоб підвищити безпеку програмного забезпечення в v3.6.0, ми покращили наші перевірки робочого процесу, інтегрувавши govulncheck для сканування вихідного коду та trivy для сканування контейнерних образів. Ці покращення також були перенесені на підтримувані стабільні релізи.
etcd продовжує дотримуватися процесу безпеки випуску для забезпечення належного керування та вирішення вразливостей.
Можливості
Міграція на v3store
v2store був визнаний застарілим з моменту випуску etcd v3.4, але його все ще можна було активувати за допомогою --enable-v2. Він залишався джерелом істини для даних про членство. У etcd v3.6.0 v2store більше не може бути активований, оскільки прапорець --enable-v2 був видалений, а v3store став єдиним джерелом істини для даних про членство.
Хоча v2store все ще існує в v3.6.0, etcd не зможе запуститися, якщо він міститиме будь-які дані, крім інформації про членство. Щоб допомогти з міграцією, etcd v3.5.18+ надає команду etcdutl check v2store, яка перевіряє, чи містить v2store лише дані про членство (див. PR 19113).
У порівнянні з v2store, v3store пропонує кращу продуктивність і транзакційну підтримку. Крім того, саме цей рушій зберігання активно підтримуватиметься надалі.
Видалення v2store все ще триває і відстежується в issues/12913.
Зниження версії
etcd v3.6.0 — це перша версія, яка повністю підтримує зниження версії. Зусилля для цього завдання зниження версії охоплюють обидві версії 3.5 і 3.6, а вся повʼязана робота відстежується в issues/11716.
На високому рівні процес охоплює міграцію схеми даних до цільової версії (наприклад, v3.5), а потім — поетапне зниження версії.
Переконайтеся, що кластер справний, і зробіть резервну копію знімка. Перевірте, чи можливе зниження версії:
$ etcdctl downgrade validate 3.5
Downgrade validate success, cluster version 3.6
Якщо зниження версії можливе, увімкніть режим зниження версії:
$ etcdctl downgrade enable 3.5
Downgrade enable success, cluster version 3.6
etcd перенесе схему даних у фоновому режимі. Після завершення перейдіть до поетапного зниження версії.
За деталями звертайтесь до керівництва Downgrade-3.6.
Функціональні можливості
У etcd v3.6.0 ми впровадили функціональні можливості (feature gates) в стилі Kubernetes для керування новими можливостями. Раніше ми позначали нестабільні можливості префіксом --experimental у назвах прапорців. Префікс видалявся, щойно можливість ставала стабільною, що спричиняло несумісну зміну. Тепер можливості починаються з Alpha, переходять до Beta, потім до GA або стають застарілими. Це забезпечує значно плавніше оновлення та зниження версії для користувачів.
Дивіться feature-gates для деталей.
Перевірки livez / readyz
etcd тепер підтримує точки доступу /livez і /readyz, що відповідає пробам життєздатності та готовності в Kubernetes. /livez вказує, чи є екземпляр etcd життєздатним, тоді як /readyz вказує, коли він готовий обслуговувати запити. Ця можливість також була перенесена на release-3.5 (починаючи з v3.5.11) і release-3.4 (починаючи з v3.4.29). Дивіться livez/readyz для деталей.
Наявна точка доступу /health залишається функціональною. /livez подібна до /health?serializable=true, тоді як /readyz подібна до /health або /health?serializable=false. Очевидно, що точки доступу /livez і /readyz надають чіткішу семантику і легші для розуміння.
v3discovery
В etcd v3.6.0 був представлений новий протокол виявлення v3discovery, заснований на clientv3. Він полегшує виявлення всіх членів кластера під час фази початкового завантаження.
Попередній протокол v2discovery, заснований на clientv2, був визнаний застарілим. Крім того, публічний сервіс виявлення за адресою https://discovery.etcd.io/, який покладався на v2discovery, більше не підтримується.
Продуктивність
Памʼять
У цьому випуску ми зменшили середнє споживання памʼяті щонайменше на 50% (див. Зображення 1). Це покращення в основному зумовлено двома змінами:
- Типове значення для
--snapshot-countбуло зменшено з 100 000 у v3.5 до 10 000 у v3.6. В результаті etcd v3.6 тепер зберігає лише близько 10% історичних записів у порівнянні з v3.5. - Історія Raft стискається частіше, про що йдеться в PR/18825.
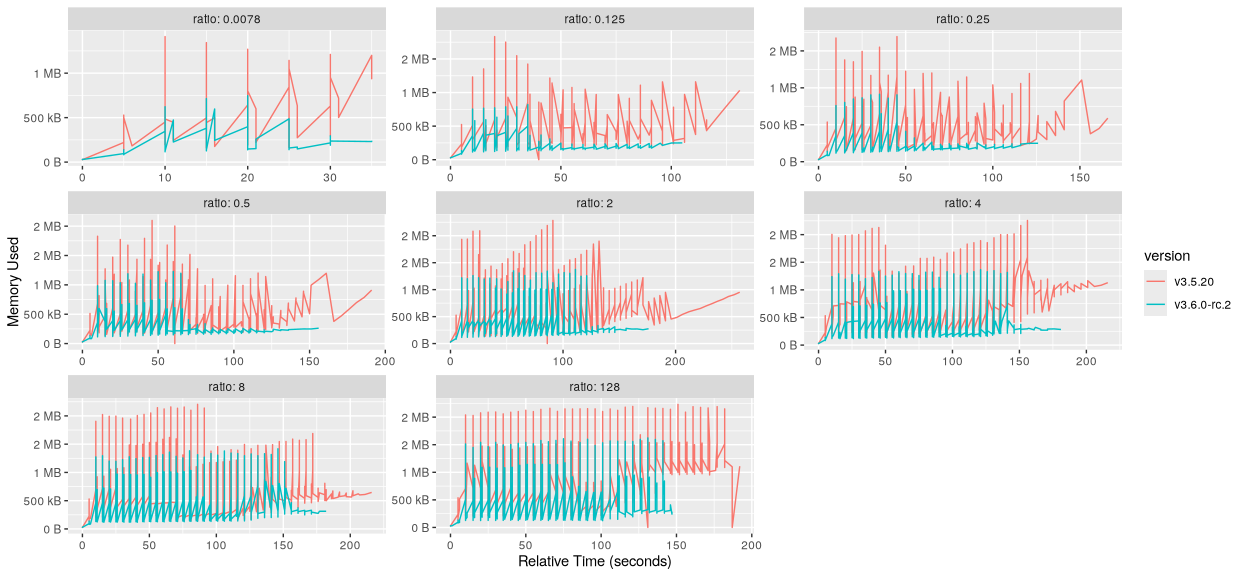
Зображення 1: Порівняння використання памʼяті між etcd v3.5.20 і v3.6.0-rc.2 за різними співвідношеннями читання/запису. Кожен графік показує використання памʼяті з часом з певним співвідношенням читання/запису. Червона лінія представляє etcd v3.5.20, тоді як бірюзова лінія представляє v3.6.0-rc.2. У всіх протестованих співвідношеннях v3.6.0-rc.2 демонструє нижче і більш стабільне використання памʼяті.
Пропускна здатність
У порівнянні з v3.5, etcd v3.6 забезпечує середнє поліпшення продуктивності приблизно на 10% як у читанні, так і в запису (див. Зображення 2, 3, 4 і 5). Це поліпшення не повʼязане з жодною окремою великою зміною, а є кумулятивним ефектом кількох незначних вдосконалень. Одним з таких прикладів є оптимізація запитів до вільних сторінок, введена в PR/419.
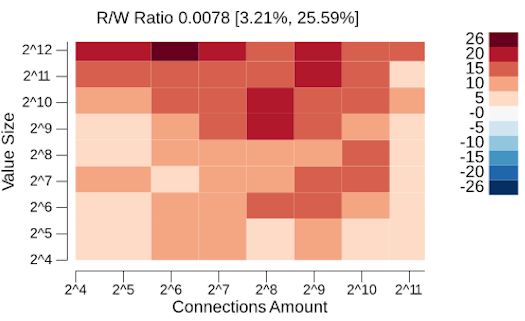
Зображення 2: Порівняння пропускної здатності читання між etcd v3.5.20 і v3.6.0-rc.2 за високого коефіцієнта запису. Коефіцієнт читання/запису становить 0.0078, що означає 1 читання на 128 записів. Права смуга показує відсоткове поліпшення пропускної здатності читання v3.6.0-rc.2 в порівнянні з v3.5.20, яке коливається від 3.21% до 25.59%.
Зображення 3: Порівняння пропускної здатності читання між etcd v3.5.20 і v3.6.0-rc.2 за високого коефіцієнта читання. Коефіцієнт читання/запису становить 8, що означає 8 читань на 1 запис. Права смуга показує відсоткове поліпшення пропускної здатності читання v3.6.0-rc.2 в порівнянні з v3.5.20, яке коливається від 4.38% до 27.20%.
Зображення 4: Порівняння пропускної здатності запису між etcd v3.5.20 і v3.6.0-rc.2 за високого коефіцієнта запису. Коефіцієнт читання/запису становить 0.0078, що означає 1 читання на 128 записів. Права смуга показує відсоткове поліпшення пропускної здатності запису v3.6.0-rc.2 в порівнянні з v3.5.20, яке коливається від 2.95% до 24.24%.
Зображення 5: Порівняння пропускної здатності запису між etcd v3.5.20 і v3.6.0-rc.2 за високого коефіцієнта читання. Коефіцієнт читання/запису становить 8, що означає 8 читань на 1 запис. Права смуга показує відсоткове поліпшення пропускної здатності запису v3.6.0-rc.2 в порівнянні з v3.5.20, яке коливається від 3.86% до 28.37%.
Кардинальні зміни
У цьому розділі висвітлено кілька помітних несумісних змін. Повний список можна знайти в Оновлення etcd з v3.5 до v3.6 та CHANGELOG-3.6.
Старі бінарні файли несумісні з новими версіями схем
Старі бінарні файли etcd несумісні з новими версіями схем даних. Наприклад, etcd 3.5 не може бути запущений з даними, створеними etcd 3.6, а etcd 3.4 не може бути запущений з даними, створеними як 3.5, так і 3.6.
При зниженні версії etcd важливо дотримуватися задокументованої процедури зниження версії. Проста заміна бінарного файлу або образу призведе до проблеми несумісності.
Точки доступу учасників більше не обслуговують запити клієнтів
Точки доступу клієнтів (--advertise-client-urls) призначені лише для обслуговування запитів клієнтів, тоді як точки доступу учасників (--initial-advertise-peer-urls) призначені виключно для звʼязку між учасниками. Однак через недогляд у реалізації точки доступу учасників також могли обробляти запити клієнтів в etcd 3.4 і 3.5. Ця поведінка була оманливою і сприяла неправильним шаблонам використання. У etcd 3.6 ця оманлива поведінка була виправлена за допомогою PR/13565; точки доступу учасників більше не обслуговують запити клієнтів.
Чітка межа між etcdctl і etcdutl
Обидва etcdctl і etcdutl є інструментами командного рядка. etcdutl є офлайн-утилітою, призначеною для роботи безпосередньо з файлами даних etcd, тоді як etcdctl є онлайн-інструментом, який взаємодіє з etcd через мережу. Раніше між ними існували деякі перекриття функціональності, але ці перекриття були усунені в 3.6.0.
-
Вилучено
etcdctl defrag --data-dirКоманда
etcdctl defragпідтримує лише онлайн-дефрагментацію і більше не підтримує офлайн-дефрагментацію. Щоб виконати офлайн-дефрагментацію, використовуйте командуetcdutl defrag --data-dir. -
Вилучено
etcdctl snapshot statusetcdctlбільше не підтримує отримання статусу знімка. Використовуйте командуetcdutl snapshot statusзамість цього. -
Вилучено
etcdctl snapshot restoreetcdctlбільше не підтримує відновлення з знімка. Використовуйте командуetcdutl snapshot restoreзамість цього.
Виправлення критичних помилок
Коректність завжди була основним пріоритетом для проєкту etcd. У процесі розробки 3.6.0 ми знайшли та виправили кілька помітних помилок, які могли призвести до неузгодженості даних у певних випадках. Ці виправлення були перенесені до попередніх версій, але ми вважаємо, що вони заслуговують на окрему згадку тут.
-
Неузгодженість даних при аварійному завершенні під навантаженням
Раніше, коли etcd застосовував дані, він спочатку оновлював consistent-index, а потім фіксував дані. Однак ці операції не були атомарними. Якщо etcd зазнавав аварії між цими операціями, це могло призвести до неузгодженості даних (див. issue/13766). Проблема зʼявилася в v3.5.0, її виправлено в v3.5.3 за допомогою PR/13854.
-
Порушення гарантії Durability API в кластері з одного вузла
Коли клієнт записує дані та отримує успішну відповідь, очікується, що дані будуть збережені. Однак дані можуть бути втрачені, якщо etcd зазнає аварії одразу після надсилання успішної відповіді клієнту. Це була стара проблема (див. issue/14370), яка впливала на всі попередні випуски. Вона була вирішена в v3.4.21 і v3.5.5 за допомогою PR/14400, і виправлена на стороні raft в основній гілці (тепер release-3.6) з PR/14413.
-
Неузгодженість ревізій при аварійному завершенні під час дефрагментації
Якщо etcd зазнавав аварії під час операції дефрагментації, після перезапуску він міг повторно застосувати деякі записи, які вже були застосовані, що призводило до проблеми з неузгодженістю ревізій (див. обговорення в PR/14685). Ця проблема зʼявилась в v3.5.0 і її було виправлено в v3.5.6 за допомогою PR/14730.
Проблема з оновленням
Цей розділ висвітлює поширену проблему issues/19557 в оновленні etcd з v3.5 до v3.6, яка може призвести до збою процесу оновлення. Для отримання докладних інструкцій з оновлення зверніться до Оновлення etcd з v3.5 до v3.6.
Ця проблема зʼявилась в etcd v3.5.1 і її було вирішено в v3.5.20.
Головне: користувачі повинні спочатку оновитися до etcd v3.5.20 (або новішої патч-версії) перед оновленням до etcd v3.6.0; інакше оновлення може зазнати невдачі.
Для отримання додаткової інформації та технічного контексту див. upgrade_from_3.5_to_3.6_issue.
Тестування
Ми впровадили тестування надійності, щоб перевірити коректність, яка завжди була нашим основним пріоритетом. Тест відтворює трафік різних типів і обсягів на кластері etcd, одночасно впроваджуючи випадкову точку відмови, записує всі операції (включаючи запити та відповіді) і, нарешті, виконує перевірку лінійної узгодженості. Він також перевіряє, що гарантії Watch APIs не були порушені. Тестування надійності підвищує нашу впевненість у забезпеченні якості кожного випуску etcd.
Ми мігрували більшість тестів робочого процесу etcd до інфраструктури тестування Prow Kubernetes, щоб використати її переваги, такі як зручні інформаційні панелі для перегляду результатів тестування та можливість для учасників повторно запускати невдалі тести самостійно.
Платформи
Зберігаючи всі наявні підтримувані платформи, ми підвищили Linux/ARM64 до рівня підтримки Tier 1. Для отримання додаткової інформації зверніться до issues/15951. Для отримання повного списку підтримуваних платформ, див. supported-platform.
Залежності
Посібник з оновлення залежностей
Ми опублікували офіційний посібник з оновлення залежностей для основної гілки та стабільних випусків etcd. У ньому також описано, як оновити версію Go. Для отримання більш детальної інформації, будь ласка, зверніться до dependency_management. Тепер, коли цей посібник доступний, будь-хто з учасників може допомогти з оновленням залежностей.
Оновлення основних залежностей
bbolt та raft є двома основними залежностями etcd.
Обидва etcd v3.4 і v3.5 залежать від bbolt v1.3, тоді як etcd v3.6 залежить від bbolt v1.4.
Для гілок release-3.4 і release-3.5 raft включено безпосередньо в репозиторій etcd, тому etcd v3.4 і v3.5 не залежать від зовнішнього модуля raft. Починаючи з etcd v3.6, raft було переміщено до окремого репозиторію (raft), а перший самостійний реліз raft — це v3.6.0. Як наслідок, etcd v3.6.0 залежить від raft v3.6.0.
Будь ласка, дивіться таблицю нижче:
| версії etcd | версії bbolt | версії raft |
|---|---|---|
| 3.4.x | v1.3.x | N/A |
| 3.5.x | v1.3.x | N/A |
| 3.6.x | v1.4.x | v3.6.x |
grpc-gateway@v2
Ми оновили grpc-gateway з v1 до v2 через PR/16595 в etcd v3.6.0. Це є важливим кроком до міграції на protobuf-go, другу основну версію реалізації API protocol buffers для Go.
grpc-gateway@v2 призначений для роботи з protobuf-go. Однак etcd v3.6 все ще залежить від застарілого gogo/protobuf, який насправді є реалізацією protocol buffers v1. Щоб вирішити цю несумісність, ми застосували патч до згенерованих *.pb.gw.go файлів, щоб перетворити повідомлення v1 на повідомлення v2.
grpc-ecosystem/go-grpc-middleware/providers/prometheus
Ми перейшли з застарілого (і архівованого) grpc-ecosystem/go-grpc-prometheus на grpc-ecosystem/go-grpc-middleware/providers/prometheus у PR/19195. Ця зміна забезпечує подальшу підтримку та доступ до останніх можливостей і вдосконалень в інтеграції gRPC Prometheus.
Спільнота
В спільноті etcd відбуваються захопливі події, які відображають нашу постійну прихильність до зміцнення співпраці, покращення підтримки та розвитку врядування проєктом.
etcd стає Kubernetes SIG
etcd офіційно став Kubernetes Special Interest Group: SIG-etcd. Ця зміна відображає критичну роль etcd як основного сховища даних для Kubernetes і встановлює більш структуровану та прозору основу для довгострокового керування та співпраці між проєктами. Нова SIG допоможе спростити процес прийняття рішень, узгодити плани з потребами Kubernetes, і залучити більше учасників.
Нові учасники, супровідники та рецензенти
Ми спостерігали активність, що постійно зростає, з боку учасників, що призвело до додавання трьох нових супровідників:
Їхній постійний внесок був вирішальним для просування проєкту вперед.
Ми також вітаємо двох нових рецензентів у проєкті:
Ми цінуємо їхню відданість якості коду та готовність взяти на себе ширші обовʼязки з рецензування в межах спільноти.
Нова команда випуску
Ми сформували нову команду випуску, очолювану ivanvc та jmhbnz, спростивши процес випуску шляхом автоматизації багатьох раніше ручних етапів. Надихнувшись Kubernetes SIG Release, ми прийняли кілька найкращих практик, включаючи чітко визначені ролі команди випуску та впровадження «тіней випуску» (release shadows) для підтримки обміну знаннями та стійкості команди. Ці зміни зробили наші випуски більш плавними та надійними, дозволяючи нам підходити до кожного випуску з більшою впевненістю та послідовністю.
Представляємо etcd Operator Working Group
Щоб ще більше покращити операційну досконалість etcd, ми сформували нову робочу групу: WG-etcd-operator. Робоча група присвячена питанням забезпечення автоматичної та ефективної роботи кластерів etcd, які працюють у середовищі Kubernetes за допомогою etcd-operator.
Майбутній розвиток
v2store був визнаний застарілим з моменту виходу etcd v3.4, а прапорець --enable-v2 був повністю видалений у v3.6. Це означає, що починаючи з v3.6, більше немає способу увімкнути або використовувати v2store. Однак всередині etcd все ще ініціалізується зі спадкових знімків v2. Щоб усунути цю неузгодженість, ми плануємо змінити etcd так, щоб він ініціалізувався з v3store і відтворити записи WAL на основі consistent-index. Ця робота відстежується в issues/12913.
Однією з найпостійніших проблем залишаються великі запити діапазону з kube-apiserver, які можуть призвести до аварійних зупинок процесів через їх непередбачувану природу. Можливість потокового діапазону, спочатку описана в v3.5 release blog/Future roadmaps, залишається ідеєю, яку варто переглянути, щоб розвʼязати проблеми з великими запитами діапазону.
Для отримання додаткової інформації та майбутніх планів, будь ласка, зверніться до планів розвитку etcd.
Огляд Kubernetes v1.30
Швидкий огляд: зміни у Kubernetes v1.30
Новий рік, новий реліз Kubernetes. Ми на половині релізного циклу і маємо чимало цікавих та чудових поліпшень у версії v1.30. Від абсолютно нових можливостей у режимі альфа до вже сталих функцій, які переходять у стабільний режим, а також довгоочікуваних поліпшень — цей випуск має щось для усіх, на що варто звернути увагу!
Щоб підготувати вас до офіційного випуску, ось короткий огляд удосконалень, про які ми найбільше хочемо розповісти!
Основні зміни для Kubernetes v1.30
Структуровані параметри для динамічного розподілу ресурсів (KEP-4381)
Динамічний розподіл ресурсів було додано до Kubernetes у версії v1.26 у режимі альфа. Він визначає альтернативу традиційному API пристроїв для запиту доступу до ресурсів сторонніх постачальників. За концепцією, динамічний розподіл ресурсів використовує параметри для ресурсів, що є абсолютно непрозорими для ядра Kubernetes. Цей підхід створює проблему для Cluster Autoscaler (CA) чи будь-якого контролера вищого рівня, який повинен приймати рішення для групи Podʼів (наприклад, планувальник завдань). Він не може симулювати ефект виділення чи звільнення заявок з плином часу. Інформацію для цього можуть надавати лише драйвери DRA сторонніх постачальників.
Структуровані параметри для динамічного розподілу ресурсів — це розширення оригінальної реалізації, яке розвʼязує цю проблему, створюючи фреймворк для підтримки параметрів заявок, що є більш прозорими. Замість обробки семантики всіх параметрів заявок самостійно, драйвери можуть керувати ресурсами та описувати їх, використовуючи конкретну "структуровану модель", заздалегідь визначену Kubernetes. Це дозволить компонентам, які обізнані з цією "структурованою моделлю", приймати рішення щодо цих ресурсів без залучення зовнішнього контролера. Наприклад, планувальник може швидко обробляти заявки без зайвої комунікації з драйверами динамічного розподілу ресурсів. Робота, виконана для цього релізу, зосереджена на визначенні необхідного фреймворку для активації різних "структурованих моделей" та реалізації моделі "пойменованих ресурсів". Ця модель дозволяє перераховувати окремі екземпляри ресурсів та, на відміну від традиційного API пристроїв, додає можливість вибору цих екземплярів індивідуально за атрибутами.
Підтримка своп-памʼяті на вузлах (KEP-2400)
У Kubernetes v1.30 підтримка своп-памʼяті на вузлах Linux отримує значущі зміни в способі її функціонування, з основним акцентом на покращенні стабільності системи. В попередніх версіях Kubernetes функція NodeSwap була типово вимкненою, а при увімкненні використовувала поведінку UnlimitedSwap. З метою досягнення кращої стабільності, поведінка UnlimitedSwap (яка може компрометувати стабільність вузла) буде видалена у версії v1.30.
Оновлена, все ще бета-версія підтримки своп на вузлах Linux буде стандартно доступною. Однак типовою поведінкою буде запуск вузла в режимі NoSwap (а не UnlimitedSwap). У режимі NoSwap kubelet підтримує роботу на вузлі, де активний простір своп, але Podʼи не використовують жодного page-файлу. Для того, щоб kubelet працював на цьому вузлі, вам все ще потрібно встановити --fail-swap-on=false. Однак велика зміна стосується іншого режиму: LimitedSwap. У цьому режимі kubelet фактично використовує page-файл на вузлі та дозволяє Podʼам виділяти деяку частину їхньої віртуальної памʼяті. Контейнери (і їхні батьківські Podʼи) не мають доступу до своп поза їхнім обмеженням памʼяті, але система все ще може використовувати простір своп, якщо він доступний.
Група Kubernetes Node (SIG Node) також оновить документацію, щоб допомогти вам зрозуміти, як використовувати оновлену реалізацію, на основі відгуків від кінцевих користувачів, учасників та широкої спільноти Kubernetes.
Для отримання додаткових відомостей про підтримку своп на вузлах Linux в Kubernetes, прочитайте попередній пост блогу чи документацію про своп на вузлах.
Підтримка просторів імен користувачів в Pod (KEP-127)
Простори імен користувачів — це функція лише для Linux, яка краще ізолює Podʼи для запобігання або помʼякшення кількох важливих CVEs із високим/критичним рейтингом, включаючи CVE-2024-21626, опубліковану у січні 2024 року. У Kubernetes 1.30 підтримка просторів імен користувачів переходить у бета-версію і тепер підтримує Podʼи з томами та без них, власні діапазони UID/GID та багато іншого!
Конфігурація структурованої авторизації (KEP-3221)
Підтримка конфігурації структурованої авторизації переходить у бета-версію та буде типово увімкненою. Ця функція дозволяє створювати ланцюги авторизації з кількома вебхуками із чітко визначеними параметрами, які перевіряють запити в певному порядку та надають деталізований контроль — такий, як явна відмова у випадку невдач. Використання конфігураційного файлу навіть дозволяє вказати правила CEL для попередньої фільтрації запитів, перш ніж вони будуть відправлені до вебхуків, допомагаючи вам запобігти непотрібним викликам. Сервер API також автоматично перезавантажує ланцюг авторизатора при зміні конфігураційного файлу.
Вам необхідно вказати шлях до конфігурації авторизації, використовуючи аргумент командного рядка --authorization-config. Якщо ви хочете продовжувати використовувати аргументи командного рядка замість конфігураційного файлу, вони продовжать працювати як є. Щоб отримати доступ до нових можливостей вебхуків авторизації, таких як кілька вебхуків, політика невдачі та правила попередньої фільтрації, перейдіть до використання параметрів у файлі --authorization-config. З версії Kubernetes 1.30 формат конфігураційного файлу є бета-рівнем, і потрібно вказувати лише --authorization-config, оскільки feature gate вже увімкнено. Приклад конфігурації із всіма можливими значеннями наведено в документації з авторизації. Докладніше читайте в документації з авторизації.
Автомасштабування Podʼів на основі ресурсів контейнера (KEP-1610)
Горизонтальне автомасштабування Podʼів на основі метрик ContainerResource перейде у стабільний стан у версії v1.30. Це нова функціональність для HorizontalPodAutoscaler дозволяє налаштовувати автоматичне масштабування на основі використання ресурсів для окремих контейнерів, а не загального використання ресурсів для всіх контейнерів у Podʼіві. Докладні відомості можна знайти у нашій попередній статті або в метриках ресурсів контейнера.
CEL для керування допуском (KEP-3488)
Інтеграція Common Expression Language (CEL) для керування допуском у Kubernetes вводить більш динамічний та виразний спосіб оцінки запитів на допуск. Ця функція дозволяє визначати та застосовувати складні, деталізовані політики безпосередньо через API Kubernetes, підвищуючи безпеку та здатність до управління без втрати продуктивності чи гнучкості.
Додавання CEL до керування допуском у Kubernetes дає адміністраторам кластерів можливість створювати складні правила, які можуть оцінювати вміст API-запитів на основі бажаного стану та політик кластера, не вдаючись до вебхуків, які використовують контролери доступу. Цей рівень контролю є важливим для забезпечення цілісності, безпеки та ефективності операцій у кластері, роблячи середовища Kubernetes більш надійними та адаптованими до різних сценаріїв використання та вимог. Для отримання докладної інформації щодо використання CEL для керування допуском дивіться документацію API для ValidatingAdmissionPolicy.
Ми сподіваємося, що ви так само нетерпляче чекаєте на цей випуск, як і ми. Стежте за блогом, щоб дізнатись про офіційний випуск через кілька тижнів, де буде представлено ще більше відомостей!
pkgs.k8s.io: Представляємо репозиторії пакунків від спільноти Kubernetes
Від імені Kubernetes SIG Release, я дуже радий представити репозиторії програмного забезпечення від спільноти Kubernetes для пакунків Debian та RPM: pkgs.k8s.io! Нові репозиторії пакунків є заміною для репозиторіїв, що надаються Google (apt.kubernetes.io та yum.kubernetes.io), які ми використовували з Kubernetes v1.5.
Цей допис містить інформацію про ці нові репозиторії пакунків, про те, що це означає для вас як кінцевого користувача, і як перейти на нові репозиторії.
ℹ️ Оновлення (26 березня 2024): застарілі репозиторії, що надаються Google, були прибрані 4 березня 2024. Більше неможливо встановлювати пакунки Kubernetes із застарілих репозиторіїв, що надаються Google. Перегляньте оголошення про припинення підтримки для отримання додаткової інформації про цю зміну.
Що вам потрібно знати про нові репозиторії пакунків?
(оновлено 12 січня 2024 та 26 березня 2024)
- Це не автоматична зміна; вам потрібно вручну перейти з використання репозиторію, що надається Google, на репозиторії, що належать спільноті Kubernetes. Дивіться як перейти далі в цьому оголошенні для інформації про міграцію та інструкцій.
- Застарілі репозиторії, що надаються Google, було прибрано 4 березня 2024. Більше неможливо встановлювати пакунки Kubernetes із застарілих репозиторіїв, що надаються Google. Ці репозиторії були визнані застарілими з 31 серпня 2023, та заморожені з 13 вересня 2023. Перегляньте оголошення про припинення підтримки для отримання додаткової інформації про цю зміну.
Застарілі репозиторії, що надаються Google, будуть прибрані у січні 2024. Ці репозиторії були визнані застарілими з 31 серпня 2023, та заморожені з 13 вересня 2023. Перегляньте оголошення про припинення підтримки для отримання додаткової інформації про цю зміну.Наявні пакунки в застарілих репозиторіях будуть доступні на невизначений час. Однак, проєкт Kubernetes не може гарантувати, як довго це буде. Застарілі репозиторії та їх вміст можуть бути видалені в будь-який час у майбутньому без додаткового попередження. Застарілі репозиторії пакунків зникнуть у січні 2024.Застарілі репозиторії, що надаються Google, були прибрані 4 березня 2024.- Оскільки нові релізи не будуть публікуватися в застарілих репозиторіях після 13 вересня 2023, ви не зможете оновитися до будь-якого патча або мінорного релізу, зробленого з тієї дати і далі, якщо ви не перейдете на нові репозиторії пакунків Kubernetes.
Тим не менш, ми рекомендуємо переходити на нові репозиторії пакунків Kubernetes якнайшвидше.Перехід на нові репозиторії пакунків Kubernetes необхідний для отримання офіційних пакунків Kubernetes. - Нові репозиторії пакунків Kubernetes містять пакунки, починаючи з тих версій Kubernetes, які все ще підтримувалися, коли спільнота взяла на себе збірку пакунків. Це означає, що нові репозиторії пакунків мають пакунки Linux для всіх релізів Kubernetes, починаючи з v1.24.0.
- Kubernetes не має офіційних пакунків Linux, доступних для попередніх релізів Kubernetes; однак, ваш дистрибутив Linux може надавати власні пакунки.
- Існує окремий репозиторій пакунків для кожної мінорної версії Kubernetes. При оновленні до іншої мінорної версії, ви повинні памʼятати, що деталі репозиторію пакунків також змінюються. Перегляньте посібник Зміна репозиторію пакунків Kubernetes для отримання інформації про кроки, які вам потрібно виконати під час оновлення мінорної версії Kubernetes.
Чому ми представляємо нові репозиторії пакунків?
Оскільки проєкт Kubernetes розвивається, ми хочемо забезпечити найкращий можливий досвід використання для кінцевих користувачів. Репозиторій, що надається Google, служив нам добре багато років, але ми почали стикатися з деякими проблемами, які вимагають значних змін у тому, як ми публікуємо пакунки. Інша мета, яку ми маємо, — це використання інфраструктури, що належить спільноті, для всіх критичних компонентів, і це включає репозиторії пакунків.
Публікація пакунків у репозиторій, що надається Google, є ручним процесом, який може виконуватися лише командою співробітників Google, Google Build Admins. Команда менеджерів релізів Kubernetes є дуже різноманітною, особливо щодо часових поясів, у яких ми працюємо. З огляду на це обмеження, нам доводиться дуже ретельно планувати кожен реліз, щоб забезпечити наявність як менеджера релізів, так і Google Build Admin для виконання релізу.
Інша проблема полягає в тому, що у нас є лише один репозиторій пакунків. Через це, ми не могли публікувати пакунки для передрелізних версій (alpha, beta та rc). Це ускладнювало тестування передрелізних версій Kubernetes для всіх, хто зацікавлений був це робити. Зворотний звʼязок, який ми отримуємо від людей, що тестують ці релізи, є критичним для забезпечення найкращої якості релізів, тому ми хочемо зробити тестування цих релізів якомога простішим. Крім того, наявність лише одного репозиторію обмежувала нас щодо публікації залежностей, таких як cri-tools та kubernetes-cni.
Незважаючи на всі ці проблеми, ми дуже вдячні Google та Google Build Admins за їх участь, підтримку та допомогу всі ці роки!
Як працюють нові репозиторії пакунків?
Нові репозиторії пакунків надаються за адресою pkgs.k8s.io для пакунків Debian та RPM. На цей час цей домен вказує на CloudFront CDN, що працює на основі кошика S3, у якому містяться репозиторії та пакунки. Однак, ми плануємо розгорнути додаткові дзеркала в майбутньому, даючи можливість іншим компаніям допомогти нам з обслуговуванням пакунків.
Пакунки збираються та публікуються платформою OpenBuildService (OBS). Після тривалого періоду оцінки різних рішень, ми прийняли рішення використовувати OpenBuildService як платформу для управління нашими репозиторіями та пакунками. По-перше, OpenBuildService є відкритою платформою, що використовується великою кількістю проєктів з відкритим кодом та компаній, таких як openSUSE, VideoLAN, Dell, Intel та інші. OpenBuildService має багато можливостей, що роблять його дуже гнучким та легким для інтеграції з нашими поточними інструментами випусків релізів. Він також дозволяє нам збирати пакунки подібним чином, як для репозиторію, що надається Google, щоб процес міграції був якомога плавнішим.
SUSE спонсорує проєкт Kubernetes надаючи доступ до свого еталонного розгортання OpenBuildService (build.opensuse.org) та технічну підтримку для інтеграції OBS з нашими процесами випусків релізів.
Ми використовуємо екземпляр OBS від SUSE для збірки та публікації пакунків. При збірці нового релізу, наші інструменти автоматично надсилають необхідні артефакти та специфікації пакунків до build.opensuse.org. Це запускає процес збірки, який збиратиме пакунки для всіх підтримуваних архітектур (AMD64, ARM64, PPC64LE, S390X). Наприкінці, згенеровані пакунки будуть автоматично надіслані до кошика S3, що належить спільноті, роблячи їх доступними для всіх користувачів.
Ми хочемо скористатися цією можливістю, щоб подякувати SUSE за дозвіл використовувати build.opensuse.org та їх щедру підтримку для здійснення цієї інтеграції!
Які значні відмінності між репозиторіями, що надаються Google, та репозиторіями пакунків Kubernetes?
Існує три значні відмінності, про які ви повинні знати:
- Існує окремий репозиторій для кожної мінорної версії Kubernetes. Наприклад, репозиторій з назвою
core:/stable:/v1.28містить лише пакунки для стабільних релізів Kubernetes v1.28. Це означає, що ви можете встановити v1.28.0 з цього репозиторію, але не можете встановити v1.27.0 або будь-яку іншу мінорну версію крім v1.28. При оновленні до іншої мінорної версії, вам потрібно додати новий репозиторій та опціонально видалити старий - Існує різниця в тому, які версії пакунків
cri-toolsтаkubernetes-cniдоступні в кожному репозиторії Kubernetes- Ці два пакунки є залежностями для
kubeletтаkubeadm - Репозиторії Kubernetes для v1.24 до v1.27 мають ті самі версії цих пакунків, що й репозиторій, що надається Google
- Репозиторії Kubernetes для v1.28 та далі будуть публікувати лише версії, що використовуються цією мінорною версією Kubernetes
- Говорячи про v1.28, лише kubernetes-cni 1.2.0 та cri-tools v1.28 будуть доступні в репозиторії для Kubernetes v1.28
- Подібно для v1.29, ми плануємо публікувати лише cri-tools v1.29 та ту версію kubernetes-cni, що буде використовуватися Kubernetes v1.29
- Ці два пакунки є залежностями для
- Частина ревізії версії пакунка (частина
-00у1.28.0-00) тепер автоматично генерується платформою OpenBuildService та має інший формат. Ревізія тепер у форматі-x.y, наприклад1.28.0-1.1
Чи впливає це якимось чином на наявні репозиторії, що надаються Google?
(оновлено 26 березня 2024)
Застарілі репозиторії, що надаються Google, були прибрані 4 березня 2024. Більше неможливо встановлювати пакунки Kubernetes із застарілих репозиторіїв, що надаються Google. Перегляньте оголошення про припинення підтримки для отримання додаткової інформації про цю зміну.
Репозиторій, що надається Google, та всі пакунки, опубліковані в ньому, будуть продовжувати працювати так само, як і раніше. Немає змін у тому, як ми збираємо та публікуємо пакунки в репозиторій, що надається Google, всі нововведені зміни впливають лише на пакунки, опубліковані в репозиторіях, що належать спільноті.
Однак, як згадувалося на початку цього допису в блозі, ми плануємо припинити публікацію пакунків у репозиторій, що надається Google, у майбутньому.
Як перейти на репозиторії пакунків від спільноти Kubernetes?
Debian, Ubuntu та операційні системи, що використовують apt/apt-get
-
Замініть визначення репозиторію
apt, щобaptвказував на новий репозиторій замість репозиторію, що надається Google. Переконайтеся, що замінили мінорну версію Kubernetes у команді нижче на мінорну версію, яку ви зараз використовуєте:echo "deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/v1.28/deb/ /" | sudo tee /etc/apt/sources.list.d/kubernetes.list -
Завантажте публічний ключ підпису для репозиторіїв пакунків Kubernetes. Той самий ключ підпису використовується для всіх репозиторіїв, тому ви можете ігнорувати версію в URL:
curl -fsSL https://pkgs.k8s.io/core:/stable:/v1.28/deb/Release.key | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpgОновлення: У релізах старіших за Debian 12 та Ubuntu 22.04, теки
/etc/apt/keyringsтипово немає, її слід створити перед виконанням команди curl. -
Оновіть індекс пакунків
apt:sudo apt-get update
CentOS, Fedora, RHEL та операційні системи, що використовують rpm/dnf
-
Замініть визначення репозиторію
yum, щобyumвказував на новий репозиторій замість репозиторію, що надається Google. Переконайтеся, що замінили мінорну версію Kubernetes у команді нижче на мінорну версію, яку ви зараз використовуєте:cat <<EOF | sudo tee /etc/yum.repos.d/kubernetes.repo [kubernetes] name=Kubernetes baseurl=https://pkgs.k8s.io/core:/stable:/v1.28/rpm/ enabled=1 gpgcheck=1 gpgkey=https://pkgs.k8s.io/core:/stable:/v1.28/rpm/repodata/repomd.xml.key exclude=kubelet kubeadm kubectl cri-tools kubernetes-cni EOF
Де я можу отримати пакунки для версій Kubernetes до v1.24.0?
(оновлено 26 березня 2024 року)
Для Kubernetes v1.24 і новіших версій пакунки Linux для компонентів Kubernetes доступні для завантаження через офіційні репозиторії пакунків Kubernetes. Kubernetes не публікує жодних пакунків програмного забезпечення для релізів Kubernetes старіших за v1.24.0; однак, ваш дистрибутив Linux може надавати власні пакунки. Крім того, ви можете безпосередньо завантажити бінарні файли замість використання пакунків. Наприклад, дивіться інструкції Without a package manager у документі "Встановлення kubeadm".
Чи можу я повернутися до репозиторію, що надається Google, після міграції до репозиторіїв Kubernetes?
(оновлено 26 березня 2024 року)
Застарілі репозиторії, що надаються Google, припинили роботу 4 березня 2024 року, тому більше неможливо повернутися до застарілих репозиторіїв, що надаються Google.
Загалом, так. Просто виконайте ті самі кроки, що й під час міграції, але використовуйте параметри для репозиторію, що надається Google. Ви можете знайти ці параметри в документі, такому як "Встановлення kubeadm".
Чому немає стабільного списку доменів/IP? Чому я не можу обмежити завантаження пакунків?
Наш план для pkgs.k8s.io полягає в тому, щоб зробити його перенаправлювачем до набору бекендів (дзеркал пакунків) на основі розташування користувача. Характер цієї зміни означає, що користувач, який завантажує пакунок, може бути перенаправлений до будь-якого дзеркала в будь-який час. З огляду на архітектуру та наші плани щодо підключення додаткових дзеркал у найближчому майбутньому, ми не можемо надати список IP-адрес або доменів, які ви можете додати до списку дозволених.
Обмежувальні механізми контролю, такі як проксі man-in-the-middle або мережеві політики, що обмежують доступ до конкретного списку IP/доменів, перестануть працювати після цієї зміни. Для цих сценаріїв ми рекомендуємо віддзеркалювати пакунки релізу до локального репозиторію пакунків, над яким ви маєте повний контроль.
Що робити, якщо я виявив якусь аномалію з новими репозиторіями?
Якщо ви зіткнулися з будь-якою проблемою з новими репозиторіями пакунків Kubernetes, будь ласка, створіть тікет в репозиторії kubernetes/release.